

-
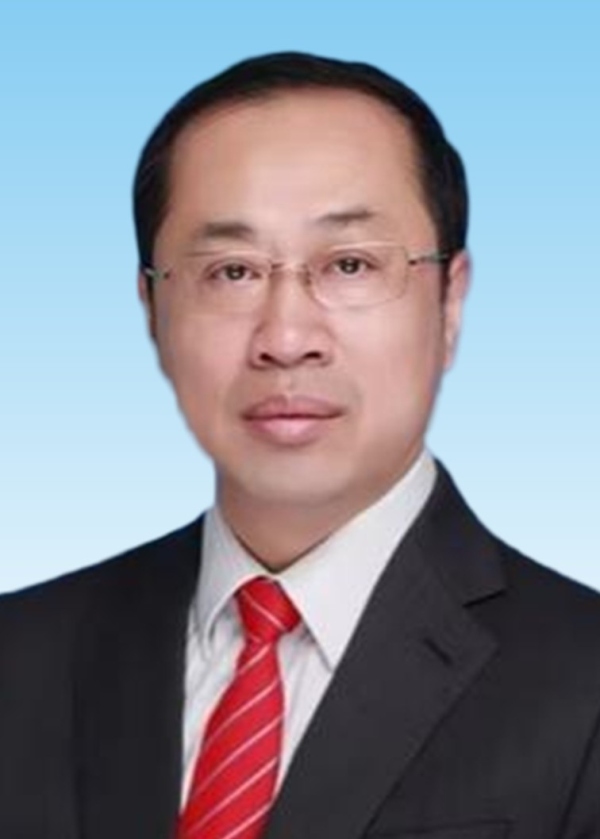
李树涛
中国科学院院士
长安大学校长个人简介:李树涛,中国科学院院士,长安大学校长,IEEE会士,中国图像图形学会副理事长、会士。曾获国家自然科学二等奖2项、国家教学成果二等奖1项、全国创新争先奖、吴文俊人工智能杰出贡献奖、IEEE GRSS David Landgrebe奖、IEEE GRSS教育奖和IEEE GRSS最高影响力论文奖等。担任Information Fusion、IEEE TGRS、中国图象图形学报等期刊编委。主要研究方向为智能信息融合感知。
报告题目:多模图像融合感知
报告摘要:多模图像融合感知旨在协同不同平台、不同传感器的图像信息,实现对物理世界更全面、更精准、更可靠地感知,在军事侦察、资源调查等国家关键战略领域具有重大应用需求,是世界大国科技竞争的制高点。本报告将介绍多模图像融合感知技术的基本原理、典型应用以及前沿挑战难题;系统阐述多模图像稀疏表示理论、时空谱智能高分融合成像方法以及多模图像智能融合识别技术等,以及相关成果在资源调查、环境保护、灾害监测等领域的应用情况,并展望了未来研究方向和发展趋势。
-
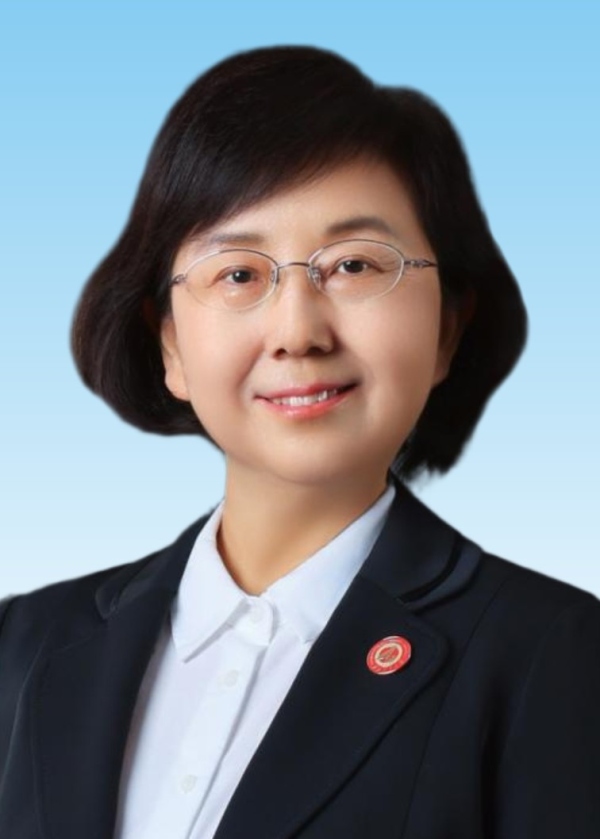
张艳宁
中国科学院院士
西北工业大学常务副校长个人简介:张艳宁,西北工业大学常务副校长,中国科学院院士、IEEE Fellow,获全国创新争先奖、中国航天基金会“钱学森杰出贡献奖”、CCF 夏培肃奖。长期从事空间环境监视动态视觉计算理论、技术研究和装备研制,并与航天、航空等方面的国家重大需求相结合,先后主持承担973、基础加强重点项目、863、国家自然科学基金重点项目、总装预研等国家级项目40余项,牵头获国家技术发明二等奖2项、国家教学成果二等奖1项、国防技术发明一等奖2项、陕西省技术发明和进步一等奖共2项等。
报告题目:智能无人系统演进、突破与走向
报告摘要:智能无人系统是人工智能未来发展的核心载体与关键方向。本报告围绕智能无人系统展开系统阐述,明晰其发展背景与核心内涵;梳理其从手动遥控到空天地海一体化自主智能的演进脉络;重点剖析当前自主智能无人系统的关键技术突破;最后展望未来发展趋势,聚焦个体智能、群体智能及空天地海一体化智能等前沿方向,为相关技术创新与产业应用提供清晰脉络与前瞻指引。
-
张文军
中国工程院院士
上海交通大学讲席教授个人简介:张文军,中国工程院院士,上海交通大学讲席教授,图像通信与网络工程研究所所长,未来媒体网络协同创新中心主任,中国电子学会会士,IEEE Fellow。长期从事图像编码与通信、媒体网络融合、宽带无线传输、视听电子系统芯片设计等领域技术研究。致力于构建我国电视广播与媒体网络领域自主技术体系,率团队承担多项国家重大科研与工程任务,取得系统性创新成果。以第一完成人获得国家科技进步二等奖四项、中国专利金奖一项、何梁何利科技进步奖和上海市科技功臣奖等荣誉。
报告题目:世界叙事模型:面向高可控内容生成
报告摘要:当前AI视频生成面临"指令稀疏、计算黑盒"的困境,可控性已成为制约产业精品化的核心瓶颈。为此,我们提出"世界叙事模型"——一个全维度、全颗粒度的时空演绎控制框架,将视频生成解耦为物理参数化世界重建、结构化叙事生成与适配接口约束渲染三个可控环节,基于"由粗到细"的分级表征渐进逼近真实4D时空。对视频通信而言,该模型带来底层范式重构潜力。6G沉浸式通信正推动视频通信从像素保真向简约物理表征演进,世界叙事模型作为物理孪生态的结构化表征,可直接承载这一范式转变:以物理参数替代原始像素传输,将通信带宽降低1-2个数量级,并从根本上解决端侧生成在空间结构、运动轨迹与光影表现上的可控性与一致性难题。面向产业落地,亟需推进两大基础工作:制定涵盖分级表征、控制接口与流化传输的多层次标准体系;建立量化参数精度、响应效能与物理语义对齐的评测基准。世界叙事模型不仅是高可控内容生成的技术底座,更将成为重构视频通信底层逻辑的战略支点。
-
朱文武
清华大学教授
个人简介:朱文武,清华大学计算机系、信息科学与技术国家研究中心教授。长期从事多媒体信息处理与大数据智能的研究。曾任国家973计划项目首席科学家,国家基金委重大项目负责人,教育部人工智能科技创新专家组成员等。三次获国家自然科学二等奖(2023年排名1, 2018年排名1 ,2012年排名2)。IEEE Fellow、ACM Fellow、AAAS Fellow、SPIE Fellow、欧洲科学院外籍院士。先后任IEEE Transactions on Multimedia主编,IEEE Transactions on Multimedia 指导委员会主席,IEEE Transactions on Circuits and Systems for Video Technology主编等。 获2023年ACM SIG多媒体杰出技术成就奖和2024年IEEE电路与系统学会Charles A. Desoer技术成就奖。
报告题目:多媒体自主智能
报告摘要:传统机器学习在感知、理解与生成等多媒体任务上取得了巨大成功,但严重依赖静态、封闭和预设的同分布假设,难以适应真实的动态开放环境。本报告首先针对感知环境的动态复杂性以及环境与机器的认知复杂性两个重大挑战,围绕数据-任务-模型的自主优化机理及环境感知与机器认知的动态演化机理这两大科学问题,提出自主机器学习的理论框架与方法体系,主要包括自主优化与自主演化理论模型。自主机器学习旨在通过主动探索感知动态环境中的持续变化,动态自适应调整数据、任务与模型,实现自适应学习与自主演化。基于自主机器学习,本报告进而提出“多媒体自主智能”这一新概念,包括多媒体数据自选择、模型自适应、任务自切换的自主优化,以及多媒体表征模型架构的自主演化等最新进展。最后,探讨多媒体具身智能学术前沿,并指出未来研究方向。
-
王海峰
百度首席技术官
报告题目:原生全模态大模型
报告摘要:多模态统一建模是当前大模型技术发展的前沿趋势之一。本报告解读万亿级原生全模态大模型,基于统一自回归框架实现文本、图像、视频与音频的多模态理解与生成。原生全模态大模型基于超稀疏混合专家(MoE)架构,通过模态无关的专家路由及共享专家池,提升跨模态学习与泛化能力;在预训练阶段首创弹性训练范式,能够在内存或时间受限场景中灵活权衡性能、模型大小和推理延迟;后训练阶段引入统一多模态强化学习,提升万亿级超稀疏大模型的收敛稳定性及多模态推理能力。得益于飞桨框架的多维混合并行训练、灵活注意力掩码等技术,模型的训练效率大幅提升。综合各项基准测试表明,原生全模态大模型在多个模态上均表现出强大且均衡的性能。
个人简介:王海峰,国家卓越工程师,百度首席技术官、深度学习技术及应用国家工程研究中心主任。自然语言处理国际学术组织ACL首位华人主席、ACL亚太分会创始主席、ACL Fellow、IEEE Fellow、国际欧亚科学院院士。兼任中国工程师联合体、中国电子学会、中国中文信息学会副理事长。以第一完成人获国家技术发明二等奖、国家科技进步二等奖、中国专利金奖、北京市科技进步一等奖、吴文俊人工智能科技进步特等奖、中国电子学会科技进步一等奖等。获光华工程科技奖、首届全国创新争先奖、首个吴文俊人工智能杰出贡献奖。入选国家百千万人才工程,被授予“有突出贡献中青年专家”称号。享受国务院政府特殊津贴。入选北京学者。
-
张正友
腾讯首席科学家
个人简介:张正友博士,腾讯首席科学家、腾讯Robotics X实验室主任、福田实验室主任。他是ACM Fellow(国际计算机学会会士)和 IEEE Fellow(国际电气电子工程师学会会士),2025年度斯坦福大学各学科22个领域的“全球前2%顶尖科学家榜单”中其“终身科学影响力”世界排名969,“年度科学影响力”世界排名588,在“AI和图像处理”领域世界排名30。世界著名的计算机视觉、语音处理、多媒体技术和机器人专家,参与了多项欧洲和微软的计算机视觉、多媒体和机器人重大项目,在立体视觉、机器人导航、运动分析、摄像机标定、人脸表情识别、语音增强与识别、沉浸式远程交互、视频会议系统等方面均有开创性贡献。他在国际顶尖会议和杂志上发表论文300余篇,论文引用次数超8万, H-index 109,专利超300项。他发明的平板摄像机标定法在全世界被普遍采用,被称之为“张氏方法”。2013年,他因为“张氏方法”获得 IEEE Helmholtz 时间考验奖。2025年他因为“Deeply-Supervised Nets” (DSN) 获得AISTATS 时间考验奖。
在2018年加入腾讯前,他是美国微软公司合伙人,微软研究院(MSR)首席研究员和研究经理,法国国家计算机和自动化研究院(INRIA)高级研究员及日本先进技术研究院(ATR)特邀研究员。 他带领的微软研究团队在微软很多产品里都有贡献,包括Windows、Office、Xbox、Kinect、Skype for Business、Office Lens等。张正友是国际计算机视觉顶级会议CVPR 2017大会共同主席,是国际认知和发育系统杂志《IEEE Transactions on Cognitive and Developmental Systems》的创始主编,国际计算机视觉杂志《International Journal of Computer Vision》的荣誉编委,国际计算机视觉和应用杂志《Machine Vision and Applications》的指导委员会委员,担任多个国际顶级期刊(包括IEEE TPAMI, IEEE TMM, IEEE TCSVT)主编副编委和国际著名会议大会主席和程序委员会主席。
报告题目:具身智能:正在发生的下一代人工智能
报告摘要:大语言模型,像ChatGPT、Gemini、和DeepSeek,已经深入到每个人的生活,但是这类生成式的人工智能是离身的智能,并不能理解我们周围的物理世界。人工智能正从 “离身” 走向 “具身”,具身智能(Embodied AI)作为下一代人工智能的核心方向,正突破传统 AI 局限,实现从数字世界到物理世界的关键跨越。本报告聚焦具身智能的技术演进、产业落地与未来趋势,系统解析其如何重塑智能形态与应用边界。具身智能的核心是让 AI 拥有物理 “身体”,通过多模态感知、自主决策与实时行动的闭环,在与物理环境的动态交互中学习进化,形成类人的适应性智能。我们从Kahneman关于系统 1 与系统 2 思维的人类智能理论,以及人脑认知相关知识中汲取灵感,提出一种面向具身智能的模块化架构与分层学习框架,命名为SLAP,旨在使机器人在复杂环境中展现出逼真的灵活性与策略性。我们将该具身智能模型成功应用于四足机器人、双足人形机器人及其它形态机器人,使其能够在复杂障碍环境中自主导航并完成复杂任务,同时涌现出自然逼真的敏捷性与策略行为。该项研究为多层级预训练知识的复用以及复杂现实任务的高效求解提供了全新思路,推动了具身智能的发展。我们也推出了国内首个模块化具身智能开放平台“钛螺丝”Tairos,为机器人提供 “即插即用” 的智能中枢。它以多模态感知、规划、感知行动联合三大模型为核心,搭配云端仿真、数据与开发工具,通过 SDK/API 开放,帮助机器人快速具备环境理解、任务规划与自主执行能力,大幅降低具身智能研发门槛。
-
权龙
香港科技大学教授
个人简介:Long QUAN is a Professor of the Department of Computer Science and Engineering at the Hong Kong University of Science and Technology.
Long Quan received the Ph.D. in Computer Science at INRIA (France) in 1989. Before joining the Department of Computer Science at the Hong Kong University of Science and Technology (HKUST) in 2001 to found the HKUST computer vision group, he has been one of the founding members of INRIA Grenoble Computer Vision Group since 1990.
He directed the founding best French PhD thesis in computer science, le prix de these Gilles Kahn in 1998, the Piero Zamperoni Best Student Paper Award in 2000, the first of six highlights of Siggraph 2007, the Best Student Poster Paper of CVPR 2008, and the ICPR 2020 Best Student Paper Award.
He has served as a General Chair of the ICCV 2011 in Barcelona, and a General Chair of the IEEE CVPR 2022 in New Orleans. He has also served as a Program Chair of ICPR 2006 Computer Vision and Image Analysis, a Program Chair of ICPR 2012 Computer and Robot Vision. He is an IEEE Fellow of the Computer Society.
He has founded the HKUST start-up Altizure.com, which has been was acquired by Apple. He has also served as a Distinguished Scientific Advisor of Apple.
报告题目:From a deterministic reconstruction to a probabilistic generation of computer vision: does it lead to a unified world representation?
报告摘要:I will first review the development of computer vision in reconstruction and understanding in the past. Then I will discuss the rapid development and the state of the art of the generative approaches in discrete languages, and continuous images and videos, then focus more on discussing the very mathematical nature of language and visual data representation, therefore on the nature of 3D generative representations in different spaces, and on the search of unified representation space in computable architectures for world modeling.
主旨报告嘉宾

