

- 多模态感知与智能评测前沿论坛
- 脑机智能技术前沿与应用创新论坛
- 数字艺术与智能叙事创新论坛
- 三维成像与显示技术前沿创新论坛
- 多模态垂域大模型与端侧智能论坛
- 多模态大模型的深度认知推理前沿技术论坛
- 视觉-语音-文字多模态智能感知与交互论坛
- 机器智能前沿论坛:微视觉计算论坛
- 视频图像安全智能化演进:感知推理与对抗论坛
- AI时代下的医学影像计算论坛
- 大模型时代的视觉智能前沿论坛
- 脑启发的全天候环境感知技术与应用论坛
- 大模型泛化的边界:长尾挑战与持续学习论坛
- 仿生感知与智能传感计算论坛
- 动态与不确定环境下的鲁棒视觉智能论坛
- 类脑智能与脑机接口论坛
- 多模态生成与理解统一模型论坛
- 面向具身智能的机器视觉与数据生成论坛
- 迈向All-in-One生成式图像复原论坛
- 多媒体可信分析与隐私计算论坛
- 具身智能手术机器人论坛
- 低质量视觉处理与质量评价论坛
- 医学影像大模型论坛
- 类脑智能与医工交叉论坛
- 面向多智能体交互的社会智能论坛
- 结构化视觉理解论坛
- 空天时空智能视觉及应用论坛
- 复杂场景下基础模型感知理解增强论坛
- 沉浸式智能媒体技术论坛
- 多模态数据的理解与生成论坛
- 多智能体协同交互论坛
- 数字文化遗产与文化智能论坛
- 深度伪造治理技术论坛
- 视觉大模型高效感知与轻量化论坛
- 生成式情感智能论坛
- 多模态交互与智能感知前沿技术论坛
- 遥感智能解译论坛:大模型还是小模型?
- 可信多模态大模型青年论坛
- 开放动态环境下的持续学习与智能演进论坛
- 物理知识引导的高效表征、学习与优化论坛
- 机器感知与智能论坛
- 三维建模生成与具身智能论坛
- 极端成像和处理前沿论坛
- 多模态生成与具身应用前沿技术论坛
- 脑机接口与脑信息智能解码论坛
- 具备物理认知的视觉智能技术前沿论坛
- 多模态视觉与空间智能前沿论坛
论坛简介
在生成式人工智能浪潮的推动下,多模态生成技术正从数字内容创作迈向与物理世界深度融合的新阶段。当模型能够理解文本、图像、视频等多模态信息,并生成具备物理合理性的内容时,人工智能便获得了与真实环境交互、执行具身任务的关键能力。这一转型的核心在于构建统一感知、生成与决策的多模态基座模型,并探索其在具身智能系统中的创新应用。
在此背景下,我们举办“多模态生成与具身应用前沿技术论坛”,汇聚领域顶尖学者,围绕多模态理解与生成、具身智能系统构建、生成式AI对科学研究的推动等前沿方向展开深入探讨。论坛旨在推动多模态生成技术向物理世界的有效延伸,促进其在智能制造等典型场景中的创新应用与落地。
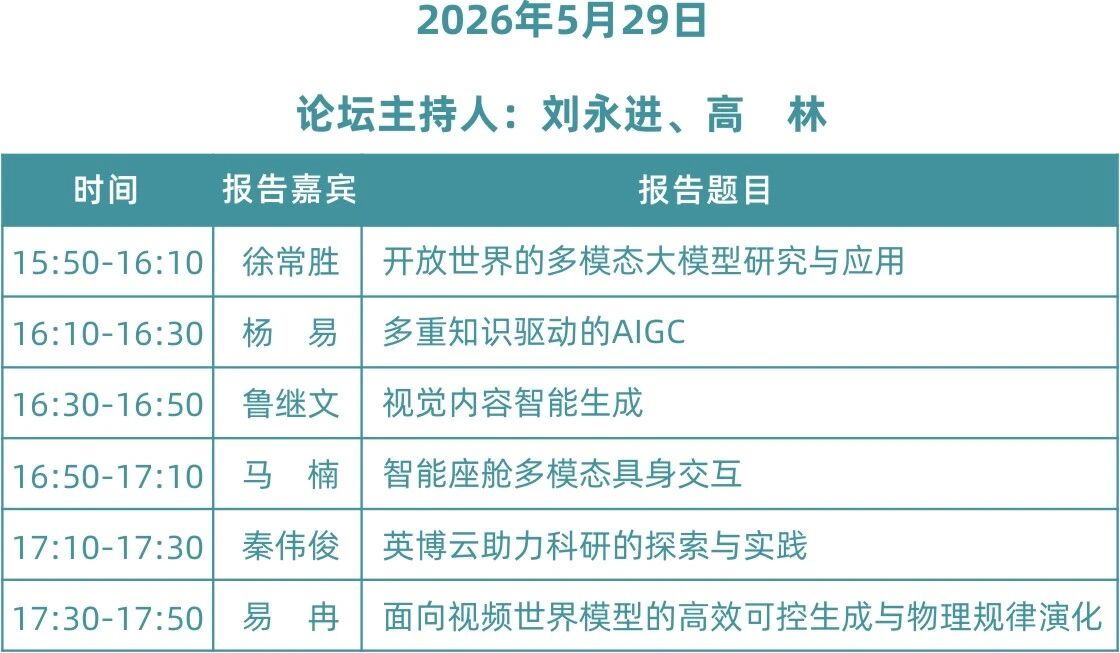
论坛日程
论坛主席
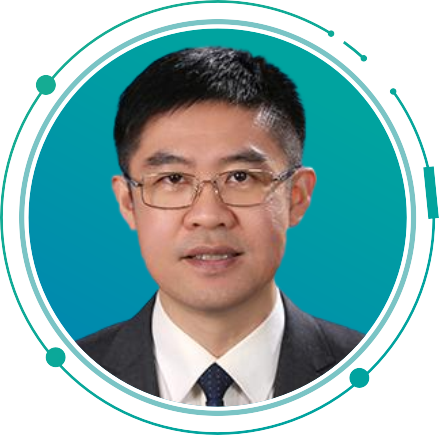
刘永进
CSIG理事
清华大学 长聘教授
个人简介:刘永进,清华大学计算机科学与技术系长聘教授、博士生导师、人机交互与媒体集成研究所所长,中国图像图形学会智能图形专委会主任,科技部某重点专项总体专家组专家,全国信息技术标准化技术委员会委员。国家杰出青年基金获得者(2018-2022)、国家优秀青年基金获得者(2014-2016),入选教育部新世纪人才计划(2011)。近五年在PAMI/ TOG/ SIGGRAPH/ TIP/ TAFFC/ TVCG/ CVPR/ AAAI/ CVPR等权威期刊会议上发表近百篇,其中SCI论文60余篇,7篇论文入选ESI高被引及热点论文。获得两次世界华人数学家联盟年度最佳论文奖(2017、2018)在内的十余项。
高 林
中国科学院计算技术研究所 研究员
个人简介:高林,研究员、博导、计算技术研究所泛在计算系统研究中心副主任、国科大岗位教授。在清华大学获得博士学位(导师:胡事民院士)。研究方向为计算机图形学。在SIGGRAPH、TPAMI、TVCG等期刊会议发表论文100余篇,研发的基于计图的人脸AIGC的APP被180余个国家或者地区的用户使用、研发的数字人系统在头部企业获得大批量落地应用。现任或曾任亚洲图形学学会秘书长, CSIG三维视觉专委副主任,CSIG智能图形专委秘书长,SIGGRAPH和SIGGRAPH Asia程序委员会委员,CVPR、NeruIPS、ICML领域主席,TVCG编委,作为项目负责人承担国家重点研发计划、国家自然科学基金委优青\重点等。
论坛讲者信息
徐常胜
中国科学院自动化研究所 研究员 报告题目:开放世界的多模态大模型研究与应用 报告摘要:与视觉和语言大模型相比,多模态大模型能够从不同模态数据中学习共性知识,因此具有更强的通用性,也更接近人类的认知能力,是目前人工智能进一步发展的关键所在。尽管目前的多模态大模型已取得了重要进展,在跨模态检索、跨模态生成等任务中取得了优异的性能,但在实际应用中面临的开放世界,已有多模态大模型仍然存在很多尚未解决的挑战。本报告主要探讨解决两个方面的问题:(1)如何在保留不同模态数据本身特性的前提下建模多模态数据关联;(2)如何在保证模型泛化性的前提下实现多模态大模型在下游任务中的跨域迁移和小样本迁移。报告分析了多模态大模型中理想的视觉系统所应具备的要素并提出了基于解耦视觉系统的多模态大模型Libra。 个人简介:徐常胜,中国科学院自动化研究所研究员,国家杰出青年基金获得者、国家万人计划领军人才、国家百千万人才工程入选者、首都科技创新领军人才、中国科学院王宽诚率先人才计划卢嘉锡国际团队负责人,IEEE/IAPR Fellow和ACM杰出科学家。担任ACM多媒体专委会中国区(ACM SIGMM China Chapter)主席。发表IEEE/ACM会刊论文200余篇,CCF-A类会议论文150余篇,在多媒体领域国际顶级会议和期刊上获得最佳论文奖10余次,以第一完成人获中国电子学会自然科学一等奖和技术发明一等奖,7次获得中国科学院优秀导师奖。
杨 易
浙江大学 教授 报告题目:多重知识驱动的AIGC 报告摘要:基于大模型的感知、推理与决策技术正成为具身智能系统的重要支撑。大模型通过融合视觉、语言等多模态信息,实现复杂环境的精准感知;利用链式推理、上下文学习和生成规划方案的能力,完成智能决策。同时,大模型显著提升了智能体之间的通信效率、协作水平和任务泛化能力,推动了多智能体系统在群体协同控制、自主导航、机器人操控、仿真交互和群智涌现等领域的广泛应用。 个人简介:杨易,浙江大学人工智能研究所所长、微软-教育部视觉感知重点实验室主任,IEEE/IAPR Fellow,浙江大学求是讲席教授、国家特聘专家,科技部2030“新一代人工智能”重大项目等国家级重大科研任务负责人。长期从事人工智能基础理论与跨学科应用研究,Google Scholar引用超9万次,H-index达149,近6年连续入选全球“高被引学者”。获教育部全国优秀博士论文(2010)、澳大利亚科研终身成就奖(2019)、中国图像图形学会自然科学一等奖(2023)、首届“祖冲之奖”(2024)及ECCV、IJCAI、AAAI、ACM MM等顶会最具影响力/最佳论文奖,并在国际竞赛中30余次夺冠, 鲁继文 清华大学 教授 报告题目:视觉内容智能生成 报告摘要:自动驾驶是人工智能与机器人领域的研究热点,在工业制造、农业生产、现代服务等领域有着重要的应用前景。报告将介绍自动驾驶视觉感知近年来的主要研究进展,包括视觉场景生成、三维占据预测、端到端自动驾驶、自动驾驶大模型等代表性方法与技术,同时深入分析其优缺点与应用潜能,最后对自动驾驶视觉感知的未来发展趋势进行展望。 个人简介:鲁继文,清华大学长聘教授、自动化系副主任、国家杰出青年科学基金获得者、IEEE/IAPR Fellow。主要研究方向包括机器视觉与模式识别、人工智能安全与治理、具身智能与机器人,发表IEEE汇刊论文160余篇(T-PAMI论文40余篇),CVPR/ICCV/ECCV论文160余篇,获授权国家发明专利60余项,主持国家重点研发计划项目1项、国家自然科学基金重点项目3项、北京市重点项目2项,获国家级教学成果二等奖1项,省部级/一级学会科技奖一等奖4项。担任中国仿真学会理事、视觉计算与仿真专委会主任,中国图像图形学会视觉认知与计算专委会副主任,中国自动化学会专家咨询工作委员会副主任,国际期刊Pat。 马 楠 北京工业大学 教授 报告题目:智能座舱多模态具身交互 报告摘要:智能驾驶座舱离不开车对人之间的智能交互,应具有良好的具身智能。然而实际场景中,座舱数据结构较为单一、用户交互模块间关联性不强,多模态感知信息获取质量及利用效率不够高,项目组长期开展基于智能座舱交互多模态数据的用户行为分析建模与评价研究,提出了智能座舱全场景自适应交互的视听触多模态数据智能获取与编码融合、基于常规行为字典与开放式行为增量的智能座舱用户行为交互模型。可交互、会学习、自成长是新一代智能机器的硬核,具身交互赋能智能座舱,更好地服务于百姓大众。 个人简介:北京工业大学人工智能学院院长、教授、博导,教育部国家重大人才工程入选者,青年北京学者,国家重点研发计划项目首席科学家,北京市智能制造与机器人技术创新专项负责人,北京市先进工作者。先后主持30余项国家、省部级等科研项目,以第一完成人先后获得中国图像图形学会科技进步一等奖、中国电子学会科学技术奖【技术发明类】二等奖,在IEEE TRO、TIP、TNNLS、中国科学.信息科学、AAAI、ICRA、ACM MM等国内外期刊、会议上发表论文百余篇,带领团队在人工智能、无人驾驶国内外赛事中获得十余次冠军。 秦伟俊 英博云 副总裁 报告题目:英博云助力科研的探索与实践 报告摘要:英博云是英博数科推出的GPU智算服务云平台,面向高校、企业及科研机构提供高效多样的GPU算力解决方案。平台采用K8S Native架构,无缝对接K8S生态;自研动态隔离控制平面(DICP)保障安全隔离,依托相关技术实现高性能存储及虚拟机与容器资源统一管理;提供多元付费模式降低使用门槛,并通过各类配套服务助力用户快速构建AI应用,践行“Easy to use,Robust to scale”的设计理念。 个人简介:秦伟俊,清华大学计算机系博士,现任北京英博数科科技有限公司副总裁,曾在快手、蚂蚁集团、百度和中国科学院从事技术发展与项目研发工作。研究领域集中在AI 大模型、多媒体、物联网等领域。 易 冉 上海交通大学 副教授 报告题目:面向视频世界模型的高效可控生成与物理规律演化 报告摘要:可视媒体智能生成能为数字孪生、虚拟现实等领域提供内容支撑,具有重要的研究价值与应用价值。报告将汇报在可视媒体智能生成方面的研究进展:在图像高效可控生成方面,将介绍文本引导的图像背景修复方法Pinco和ATA,扩散模型高效微调方法SaRA,改进的自回归视觉生成方法IAR;在视频高效可控生成方面,将介绍视频主体定制化方法PolyVivid和HunyuanCustom,运动可控视频生成方法MotionMaster和PoseAnything,4K高清视频高效生成方法UltraGen,以及音视频联合生成方法Harmony,所提出的方法在生成质量、主体一致性、可控生成的精准性等方面取得明显提升。 个人简介:易冉,博士,上海交通大学计算机学院副教授、博士生导师。入选中国科协“青年人才托举工程”、上海市扬帆计划。从事计算机图形学、媒体智能生成方向的研究。发表录用100篇论文于IEEE TPAMI、ACM TOG、SIGGRAPH、CVPR等期刊会议,其中CCF-A类论文70余篇。获北京市科技进步二等奖,中国图像图形学会高等教育教学成果一等奖,中国图像图形学会石青云女科学家奖(青英组),CCF-腾讯犀牛鸟基金卓越项目,瑞士Chorafas青年研究奖,数博会十大领先科技成果,ACM SIGAI China新星奖,吴文俊人工智能优秀博士学位论文,中国产学研合作创新成果奖优秀奖,中国计算机学会产学合作基
论坛联系人
姓名:易冉
单位和职称:上海交通大学副教授
邮箱:ranyi@sjtu.edu.cn

