

- 多模态感知与智能评测前沿论坛
- 脑机智能技术前沿与应用创新论坛
- 数字艺术与智能叙事创新论坛
- 三维成像与显示技术前沿创新论坛
- 多模态垂域大模型与端侧智能论坛
- 多模态大模型的深度认知推理前沿技术论坛
- 视觉-语音-文字多模态智能感知与交互论坛
- 机器智能前沿论坛:微视觉计算论坛
- 视频图像安全智能化演进:感知推理与对抗论坛
- AI时代下的医学影像计算论坛
- 大模型时代的视觉智能前沿论坛
- 脑启发的全天候环境感知技术与应用论坛
- 大模型泛化的边界:长尾挑战与持续学习论坛
- 仿生感知与智能传感计算论坛
- 动态与不确定环境下的鲁棒视觉智能论坛
- 类脑智能与脑机接口论坛
- 多模态生成与理解统一模型论坛
- 面向具身智能的机器视觉与数据生成论坛
- 迈向All-in-One生成式图像复原论坛
- 多媒体可信分析与隐私计算论坛
- 具身智能手术机器人论坛
- 低质量视觉处理与质量评价论坛
- 医学影像大模型论坛
- 类脑智能与医工交叉论坛
- 面向多智能体交互的社会智能论坛
- 结构化视觉理解论坛
- 空天时空智能视觉及应用论坛
- 复杂场景下基础模型感知理解增强论坛
- 沉浸式智能媒体技术论坛
- 多模态数据的理解与生成论坛
- 多智能体协同交互论坛
- 数字文化遗产与文化智能论坛
- 深度伪造治理技术论坛
- 视觉大模型高效感知与轻量化论坛
- 生成式情感智能论坛
- 多模态交互与智能感知前沿技术论坛
- 遥感智能解译论坛:大模型还是小模型?
- 可信多模态大模型青年论坛
- 开放动态环境下的持续学习与智能演进论坛
- 物理知识引导的高效表征、学习与优化论坛
- 机器感知与智能论坛
- 三维建模生成与具身智能论坛
- 极端成像和处理前沿论坛
- 多模态生成与具身应用前沿技术论坛
- 脑机接口与脑信息智能解码论坛
- 具备物理认知的视觉智能技术前沿论坛
- 多模态视觉与空间智能前沿论坛
论坛简介
近年来,三维视觉领域的核心任务正从“感知重建”逐步转向“重建—生成—交互”一体化的新阶段。三维重建、三维生成与具身智能这三个先前相对独立的研究任务之间的关系变得愈加紧密。本论坛由三维视觉专委会负责组织,专委会主任和秘书长担任论坛主席,拟邀请领域内的知名学者对三维重建、三维生成与具身智能的前沿技术及最新进展做深入介绍,并通过Panel环节探讨这三个任务的发展趋势、分析当前能力边界与核心瓶颈以及展望未来的演进路径。
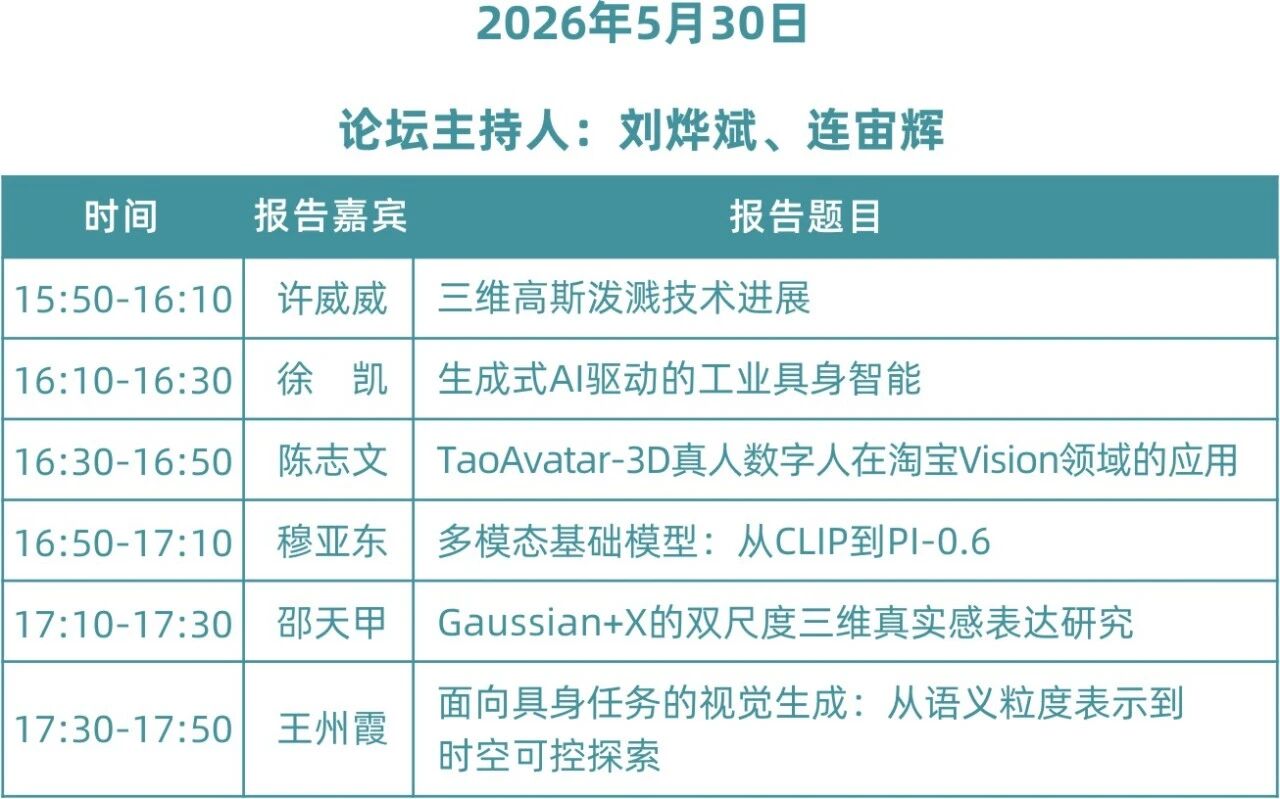
论坛日程
论坛主席
刘烨斌
CSIG理事 清华大学 教授 个人简介:刘烨斌,清华大学自动化系长聘教授,国家基金委杰青。研究方向为三维视觉、数字人重建与生成。担任IEEE TCVG、CGF编委,多次担任CVPR、ICCV、ECCV领域主席,SIGGRAPH Asia技术委员会委员。任中国图像图形学会三维视觉专委会主任。获2012年国家技术发明一等奖(排名3),2019年中国电子学会技术发明一等奖(排名1)。
连宙辉
北京大学 长聘副教授 个人简介:连宙辉,北京大学王选计算机研究所长聘副教授、研究员、博士生导师,中国文字字体设计与研究中心副主任,入选国家级青年人才计划和北京市科技新星计划。主要研究方向是图形图像生成与三维视觉,在领域重要期刊和会议上发表论文100余篇。多次担任SIGGRAPH Asia、NeurIPS、CVPR、ICCV、ICML、ECCV等国际会议领域主席(或相当职务),担任CSIG三维视觉专委会秘书长,获北京市技术发明奖二等奖(排名1)、中国专利优秀奖(排名1)、ICRA2024服务机器人最佳论文候选、吴文俊人工智能优秀青年奖等奖励。
论坛讲者信息
许威威
浙江大学 教授 报告题目:三维高斯泼溅技术进展 报告摘要:近年来,三维场景的端到端重建技术极大提升了从图像自动恢复三维表达的自动化程度,在基于图像的绘制、逆向重建等领域获得了快速的发展。该表达可通过可微绘制技术从传感器数据直接构建几何和材质的隐式表达,简化了传统场景构建技术流程,支持自由视点绘制、体积视频和全息会议等虚拟现实应用。本报告聚焦于介绍3DGS在场景重建、材质计算、人体重建等三维内容构建上取得的进展进行介绍。 个人简介:许威威,浙江大学计算机科学与技术学院CAD&CG国家重点实验室长聘教授,教育部长江学者。曾任日本立命馆大学博士后,微软亚洲研究院网络图形组研究员, 杭州师范大学浙江省钱江学者特聘教授。主要研究方向为智能三维感知、重建和仿真。在国内外高水平学术会议和期刊发表论文100余篇,其中ACM Transactions on Graphics, IEEE TVCG、IEEE CVPR、AAAI等CCF-A类论文60余篇。获中国和美国授权专利15项。所开发的高精度、高真实感三维重建技术在先临高精度扫描仪、百度阿波罗自动驾驶仿真平台、华为河图和徐工机械远程驾驶舱、凌迪数码服装仿真中得到应用。2014年受国家自 徐 凯 中国科学院工业人工智能研究所 研究员 报告题目:生成式AI驱动的工业具身智能 报告摘要:随着制造业向柔性化与高端化转型,具身智能面临任务复杂性与作业精准性双重挑战。本报告探讨工业具身智能在感知、控制与决策中面临的适应性与精准性协同的挑战。针对感知端(工业之眼),探讨利用生成式AI弥补大规模标注数据缺失,实现复杂工况下的高精度AI成像感知;在控制端(工业之手),探讨由物理机理引导的生成式作业技能学习,突破柔性适应与高精度作业的矛盾;在决策端(工业之脑),通过生成式方法构建产线逻辑,提升动态制造流程下的响应效率。最后探讨“眼-手-脑”的深度耦合机制,并展望由“工厂世界模型”驱动的工业具身智能新范式。 个人简介:徐凯,中国科学院工业人工智能研究所研究员。曾任国防科技大学教授、普林斯顿大学访问学者、加拿大西蒙弗雷泽大学客座教授。研究方向为计算机图形学、三维视觉、具身智能、数字孪生等。在国际上较早开展了数据驱动三维感知、建模与交互工作,提出面向复杂场景的结构引导、机理增强的感知-建模-交互理论方法系统,并规模化应用于重工、船舶、汽车等智能制造领域。主持国家自然科学基金青年科学基金A类(原杰青)、B类(原优青)、重点项目等。连续多年入选全球前2%顶尖科学家榜单。担任图形领域顶级国际期刊ACM Transactions on Graphics、IEEE Transactions on Visualization 陈志文 淘天集团 3D真人数字人技术负责人 报告题目:TaoAvatar-3D真人数字人在淘宝Vision领域的应用 报告摘要:本报告将系统介绍 TaoAvatar-3D 真人数字人技术在淘宝 Vision 产品中的探索与应用,涵盖三维重建、AI 语音驱动等前沿创新成果。依托这些技术突破,淘宝 Vision 先后推出 TaoAvatar 3D 真人模特与 3D 真人导购,并分别在 2025 年服贸会、数贸会以及淘宝 Vision 未来旗舰店成功落地。在实际应用中,TaoAvatar 能以自然流畅的语气与精准专业的讲解,为观众生动呈现最新产品,带来沉浸式、互动化的3D购物体验。值得特别关注的是,TaoAvatar 的相关研究已发表于 CVPR 2025及2026,并同步开源了数据集与 Demo,进一步推动了 3D 真人数字人技术在行业中的创新与落地。 个人简介:陈志文,现任淘天集团-3D真人数字人技术负责人,负责3D真人重建、驱动及AI交互等相关技术创新。曾主导淘宝直播官方数字人主播技术的从零到一落地,并长期负责端侧AR电商相关技术研发。在CVPR、ICLR、ACMMM等顶级会议发表多篇论文,在CVPR、ICCV等多个国际竞赛中获得冠军。参与并荣获2023年度中国计算机学会(CCF)科技进步一等奖。 穆亚东 北京大学 研究员 报告题目:多模态基础模型:从CLIP到PI-0.6 报告摘要:多模态大模型是人工智能领域近期的研究热点之一,通过融合视觉、语言、动作等模态数据,正在向具身智能和通用智能方向演进。本报告重点探讨了其架构设计、核心要素及前沿应用场景,特别是讲者所负责的实验室在多模态具身大模型方面的近期研究进展,包括视觉语言导航模型、基于思考链的具身大脑RoboAgent、基于闭环控制的具身TEA模型等、以及在具身tokenization等方面的一些研究进展等。 个人简介:穆亚东,北京大学长聘副教授、北大博雅青年学者、北京智源学者,新闻出版智能媒体技术重点实验室副主任,先后在北京大学获得理学学士和理学博士学位。曾在新加坡国立大学、美国哥伦比亚大学、华为香港诺亚方舟实验室、美国电话电报公司研究院(AT&T Labs)担任研究职位,主要研究领域为计算机视觉和机器人学,在CVPR等中国计算机学会论文推荐列表A类会议和T-PAMI等ACM/IEEE汇刊发表论文超过90篇,申请PCT、美国或中国专利40余项。获得陕西省自然科学一等奖、国际会议SIGIR最佳论文提名奖、北京大学京东方奖教金、杨王院士奖教金等。担任多媒体领域旗舰期刊IEEE Transactions on M 邵天甲 浙江大学 长聘副教授 报告题目:Gaussian+X的双尺度三维真实感表达研究 报告摘要:三维高斯泼溅(3DGS)是当前主流的三维真实感表达,在高保真辐射场绘制与三维重建中表现突出。但其绘制依赖基于分块的高斯空间排序,存在固有的视点不一致问题,视角移动易引发时序闪烁伪影;同时三维高斯优化计算开销大,难以满足实时在线三维重建需求。针对上述瓶颈,本文开展Gaussian+X (如二维面元、有向距离场等)双尺度真实感表达研究,所提方法实现超高速高保真辐射场绘制,帧率达 650+fps,有效解决 3DGS 视点不一致与时序闪烁问题;同时完成高实时三维高保真重建,重建速度 150+fps,显著降低计算代价。该研究为真实感绘制与实时三维重建提供了高效可行的技术方案。 个人简介:邵天甲,浙江大学CAD&CG全国重点实验室长聘副教授、博士生导师,获国家自然科学基金优秀青年基金项目资助。之前在英国利兹大学(University of Leeds)担任Lecturer(终身教职)。研究方向是计算机图形学和三维视觉,包括三维重建,数字人、3D AIGC等。已在计算机图形学和视觉的顶级期刊和会议(TOG, SIGGRAPH, TVCG, CVPR等)发表CCF-A类论文40余篇。他是ACM SIGGRAPH 2022/2023程序委员,CVM 2022程序委员会共同主席,现担任The Visual Computer和Computer&Graphics编委,中国电子学会虚拟现实分会总干事。 王州霞 中山大学 副教授 报告题目:面向具身任务的视觉生成:从语义粒度表示到时空可控探索 报告摘要:具身智能的实现不仅依赖于强大的感知,更依赖于对物理世界进行高效表示与精准模拟的能力。本报告将围绕“表示、控制、应用”三个维度,分享我们在构建具身视觉生成模型方面的探索。 个人简介:王州霞,国家级青年人才,中山大学预聘副教授。博士毕业于香港大学MMLAB-HKU,研究生毕业于中山大学;曾在南洋理工大学MMLab-NTU任博士后研究员。已发表多篇国际顶级会议和期刊论文(CVPR、ICCV、SIGGRAPH、ICLR、AAAI、IJCV、TPAMI、TIP、IJCV等)。长期担任TPAMI、TIP、IJCV、CVPR、ICCV、ECCV、NeurIPS、SIGGRAPH等国际顶级期刊和会议的审稿人。研究方向涵盖视觉理解与内容生成技术,包括高级视觉语义理解、底层视觉语义修复、图像/视频可控生成等。
论坛联系人
姓名:连宙辉
单位和职称:北京大学长聘副教授
邮箱:lianzhouhui@pku.edu.cn

