

- 多模态感知与智能评测前沿论坛
- 脑机智能技术前沿与应用创新论坛
- 数字艺术与智能叙事创新论坛
- 三维成像与显示技术前沿创新论坛
- 多模态垂域大模型与端侧智能论坛
- 多模态大模型的深度认知推理前沿技术论坛
- 视觉-语音-文字多模态智能感知与交互论坛
- 机器智能前沿论坛:微视觉计算论坛
- 视频图像安全智能化演进:感知推理与对抗论坛
- AI时代下的医学影像计算论坛
- 大模型时代的视觉智能前沿论坛
- 脑启发的全天候环境感知技术与应用论坛
- 大模型泛化的边界:长尾挑战与持续学习论坛
- 仿生感知与智能传感计算论坛
- 动态与不确定环境下的鲁棒视觉智能论坛
- 类脑智能与脑机接口论坛
- 多模态生成与理解统一模型论坛
- 面向具身智能的机器视觉与数据生成论坛
- 迈向All-in-One生成式图像复原论坛
- 多媒体可信分析与隐私计算论坛
- 具身智能手术机器人论坛
- 低质量视觉处理与质量评价论坛
- 医学影像大模型论坛
- 类脑智能与医工交叉论坛
- 面向多智能体交互的社会智能论坛
- 结构化视觉理解论坛
- 空天时空智能视觉及应用论坛
- 复杂场景下基础模型感知理解增强论坛
- 沉浸式智能媒体技术论坛
- 多模态数据的理解与生成论坛
- 多智能体协同交互论坛
- 数字文化遗产与文化智能论坛
- 深度伪造治理技术论坛
- 视觉大模型高效感知与轻量化论坛
- 生成式情感智能论坛
- 多模态交互与智能感知前沿技术论坛
- 遥感智能解译论坛:大模型还是小模型?
- 可信多模态大模型青年论坛
- 开放动态环境下的持续学习与智能演进论坛
- 物理知识引导的高效表征、学习与优化论坛
- 机器感知与智能论坛
- 三维建模生成与具身智能论坛
- 极端成像和处理前沿论坛
- 多模态生成与具身应用前沿技术论坛
- 脑机接口与脑信息智能解码论坛
- 具备物理认知的视觉智能技术前沿论坛
- 多模态视觉与空间智能前沿论坛
论坛简介
持续学习(Continual Learning)是人工智能与机器学习领域中的一项前沿研究方向,其目标在于构建能够在连续到达的数据流和任务序列中以增量方式不断获取新知识、并持续提升认知能力的智能模型,从而更接近人类长期学习的认知机制。持续学习被普遍视为人类智能的标志性能力之一,也是实现类人水平人工智能的重要基础属性。然而,现有深度学习模型在顺序学习新任务或新知识时,往往会显著遗忘已掌握的旧知识,即所谓的灾难性遗忘问题,这已成为制约持续学习发展的核心挑战。针对上述问题开展持续学习研究,有助于推动人工智能系统从“静态训练、一次部署”的模式,向“长期学习、持续进化”的范式转变。
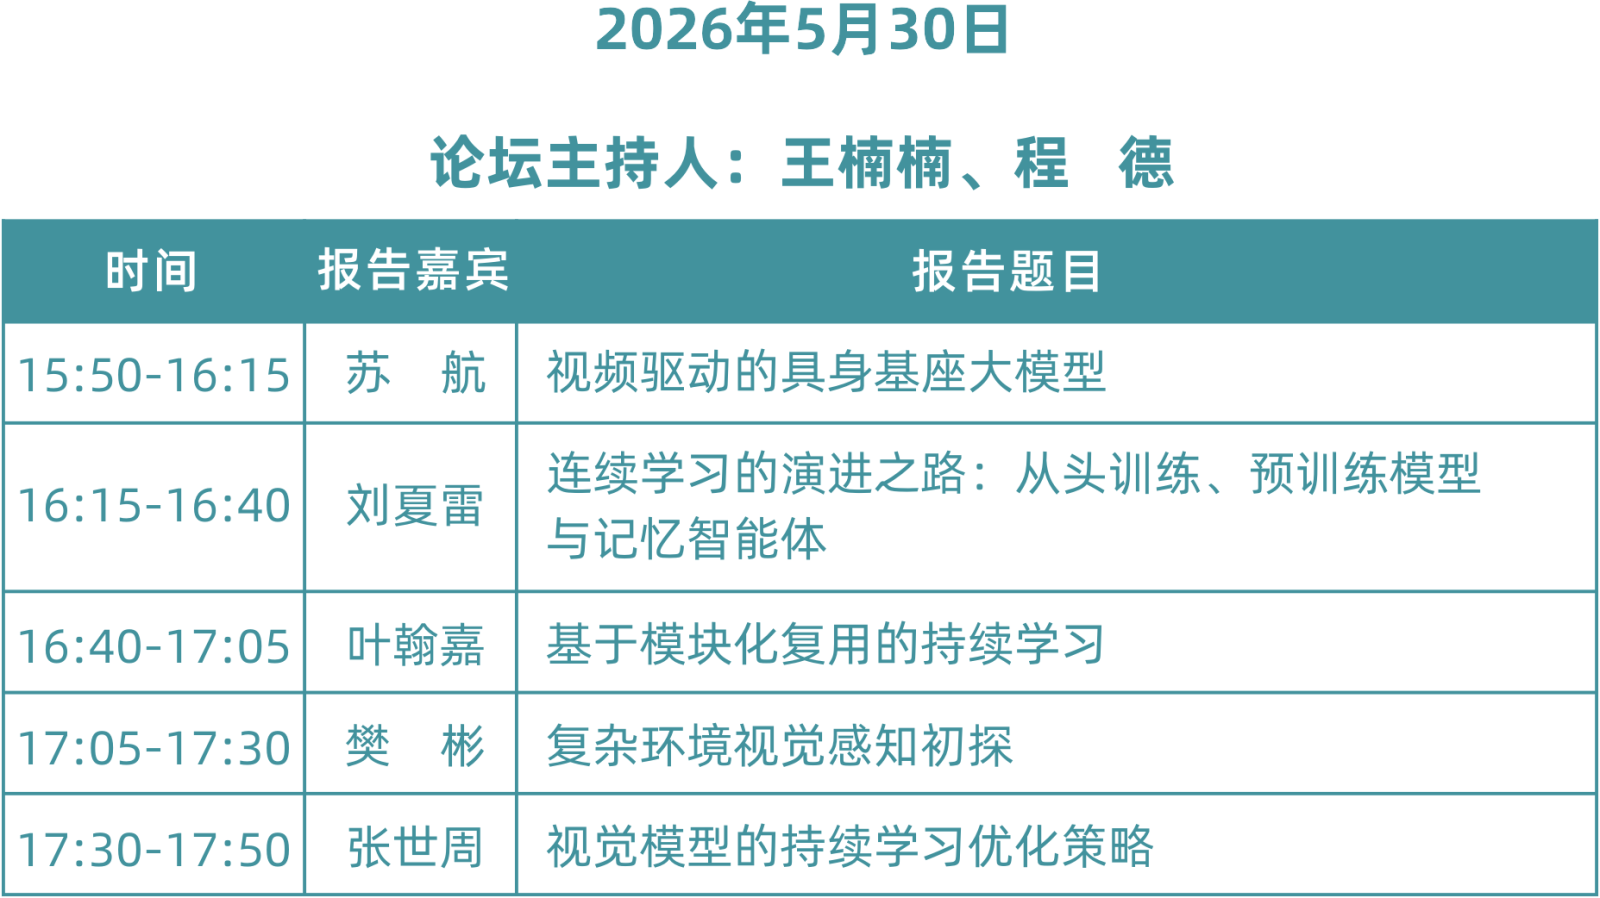
论坛日程
论坛主席
王楠楠
西安电子科技大学 教授 个人简介:王楠楠,教授,博士生导师,现任西安电子科技大学空天地一体化综合业务网全国重点实验室副主任,目前挂职担任西北大学电子信息学院(人工智能学院)院长。主要研究方向为计算机视觉与统计机器学习,专注于图像跨域重建与识别,包括画像-照片合成与识别、超分辨率重建、图像恢复、行为分析、行人重识别等。在IEEE TPAMI、IJCV、CVPR、ICCV等顶级期刊会议上发表论文150余篇,授权专利40余项,获中国图像图形学会自然科学奖一等奖(R1)、教育部自然科学奖一等奖(R2)等,主持国家自然科学基金优秀青年基金项目、联合基金重点项目等项目。目前是陕西省科技创新团队负责人、三秦特支计划创新团队负责人。 程 德 西安电子科技大学 副教授 个人简介:程德,西安电子科技大学副教授、博士生导师。分别于2011和2017年在西安交通大学获得本科和博士学位,美国卡内基梅隆大学联合培养博士,曾任华为公司主任工程师。主要研究方向为计算机视觉、机器学习等,近年来已在该领域权威期刊/会议发表论文100余篇,第一/通讯作者发表IEEETrans./中国科学院一区Top权威期刊、CCF-A 类国际会议70篇(其中包含T-PAMI/IJCV 7篇,CCF-A类会议论文35篇), 谷歌学术总引用4000余次,一作单篇论文最高被引1600余次,ESI高被引论文2篇,授权发明专利20余项,相关技术应用于研究所和企业。目前主持国家自然科学基金面上项目2项、国家重点研发计划子课题、陕西省重点研发计划、国家自然科学基金区域联合基金重点项目—课题等项目。 论坛讲者信息 苏 航 清华大学 副教授 报告题目:视频驱动的具身基座大模型 报告摘要:随着具身智能加速迈向通用化和复杂场景应用,如何有效贯通环境理解、未来推演、动作生成与控制执行,正成为构建通用机器人基础模型的关键问题。视频天然包含状态变化、物体交互和动作演化等连续时空信息,为统一表征环境动态与行为先验提供了重要载体。本报告围绕视频具身基座大模型,介绍一条从视频建模走向动作推理、闭环控制、统一世界模型与持续学习的发展路径。首先,Vidar 通过大规模多视角视频预训练与 masked inverse dynamics 相结合,将视频扩散模型从视觉生成工具推进为可恢复动作信息的具身表征模型,在低样本条件下实现了跨任务、跨平台的泛化操作能力。进一步地,Vidarc 在此基础上引入自回归视频扩散与实时反馈机制,使视频驱动模型能够支持低时延闭环控制,显著提升在线纠错能力与真实部署性能。最后,Motus 进一步打通理解、视频生成、动作预测和世界建模之间的边界,提出统一潜在动作世界模型。 个人简介:苏航,清华大学计算机系副研究员,入选国家“万人计划”青年拔尖人才,主要研究鲁棒机器学习和具身决策等相关领域,发表CCF推荐A类会议和期刊论文100余篇,谷歌学术论文引用15000余次,受邀担任人工智能领域顶级期刊IEEE TPAMI和Artificial Intelligence的编委,IEEE生成式大模型安全工作组主席,获得吴文俊人工智能自然科学一等奖,ICME铂金最佳论文、MICCAI青年学者奖和AVSS最佳论文等多个学术奖项,曾率队在NeurIPS2017对抗攻防等多个国际学术比赛中获得冠军。现任中国图像图形学会青工委执委、曾任VALSE执行AC委员会主席,NeurIPS21的领域主席(Area Chair)、AAAI22 Workshop Co-Chair等。 刘夏雷 南开大学 副教授 报告题目:连续学习的演进之路:从头训练、预训练模型与记忆智能体 报告摘要:连续学习旨在赋予人工智能系统在动态环境中持续吸收新知、克服灾难性遗忘的能力,是迈向人类般增量式智能的核心路径。本报告将系统梳理连续学习的演进之路,涵盖从传统的“从头训练”范式,到基于预训练模型的“高效迁移”范式,再到面向未来智能体的“自主持续演进”范式。在此基础上,报告人将结合自身在不同阶段的研究实践,介绍其代表性工作。 个人简介:刘夏雷:南开大学计算机学院副教授,博士生导师,国家高层次青年人才计划入选者,研究方向为开放环境视觉连续学习。入选南开大学“百名青年学科带头人培养计划”,入选第九届中国科协青年托举计划。博士毕业于西班牙巴塞罗那自治大学,博士后工作于英国爱丁堡大学。长期从事连续学习、无监督学习和小样本学习等面向开放环境的机器学习和计算机视觉问题。至今共发表学术论文40余篇,谷歌学术引用6000余次。包含国际顶级期刊和会议TPAMI、NeurIPS、CVPR、ICCV等,一篇文章入选CVPR 2022 Best Paper Finalists。担任VALSE 2022-2026 组委会成员,组织CVPR 2023年连续学习Workshop,获第二届粤港澳大湾区(黄埔)国际算法算例大赛“序列任务的连续学习”冠军。 叶翰嘉 南京大学 副教授 报告题目:基于模块化复用的持续学习 报告摘要:持续学习关注当新知识不断增加时如何利用已有模型和新增数据进行模型高效更新。对新数据的微调往往会导致神经网络 “灾难性遗忘”,即模型在学习“新知识”的同时易快速遗忘“旧知识”,不利于模型在开放环境中应用。本报告从“模块化复用”的视角出发,通过保持模型主体稳定防止遗忘,并对最关键的参数和模块进行受控更新与按需调用,实现模型能力的持续演进。例如,在连续测试时适配场景下,利用分类器确定在线更新方向,并在低秩子空间中进行轻量适配,使模型在动态分布变化下具有更稳定的性能和更高的适应效率。这一思路也可应对多模态大模型长链推理中的视觉信息遗忘,通过将可复用知识显式解耦为视觉记忆与推理记忆,并利用路由机制按状态决定“调用什么、调用多少”,使模型在更长的推理过程中不易丢失关键信息,同时减少冗余生成,提升整体推理效果。 个人简介:叶翰嘉现任南京大学人工智能学院副教授、博导,在南京大学机器学习与数据挖掘研究所(LAMDA)从事学术研究工作,研究方向包括表示学习、预训练模型复用等领域。叶翰嘉在人工智能领域发表《IEEE Trans. PAMI》等学术论文80余篇,受邀担任国际重要会议ICML/ICLR/CVPR/ IJCAI/AAAI领域主席、期刊TPAMI、TMLR(执行)编委;主持国家自然科学基金青年科学基金B类项目、国家重点研发计划专项项目,获中国人工智能学会吴文俊人工智能青年科技奖、中国计算机学会优秀博士学位论文奖。 樊 彬 北京科技大学 教授 报告题目:复杂环境视觉感知初探 报告摘要:智能无人系统视觉感知是实现人工智能的核心技术之一,在机器人、自动驾驶、工业检测等智能无人系统应用中具有重要的应用价值。随着视觉传感器质量的不断提升,以及深度学习技术的持续发展,成像可控条件下的目标识别、语义分割、目标跟踪等感知任务的精度得到很大提升,然而,真实应用环境具有复杂开放特性,视觉感知面临视觉信息退化、应用场景不可控等挑战,如何提高复杂环境视觉感知能力是当前急需解决的问题。本报告将汇报我们在该方面所做的一些初步尝试,包括面向恶劣环境的视觉感知和连续学习等方法。 个人简介:樊彬,北京科技大学人工智能学院教授、博士生导师、小米青年学者,国家优秀青年科学基金获得者。担任中国自动化学会模式识别与机器智能专委会秘书长,《Pattern Recognition》等期刊的编委以及顶级会议CVPR等领域主席,发表中国科学院一区、IEEE Trans和CCF-A类论文50余篇,Google引用8000余次,连续入选斯坦福大学评选的全球前2%顶尖科学家榜单,获中国科协青年人才托举工程、中国电子学会自然科学一等奖、中国自动化学会自然科学一等奖等奖励荣誉。 张世周 西北工业大学 副教授 报告题目:视觉模型的持续学习优化策略 报告摘要:随着视觉模型在实际应用中的广泛部署,如何在持续学习(Continual Learning)场景下保持性能成为核心挑战。传统训练方法在对象检测和分类任务中易导致灾难性遗忘(Catastrophic Forgetting)。为缓解该问题,研究者提出多种策略,包括视觉提示调优(Visual Prompt Tuning)、注意力保持(Attention Retention)、基于类原型的近邻方法以及生成式重放(Generative Replay)。在Transformer架构下,通过在特征空域进行重要性感知提示调优,可在保留旧知识的同时高效学习新任务;在增量对象检测中,质量引导的匹配策略和实时检测方法(如YOLO-IOD)可兼顾精度与延迟。本文报告系统梳理上述方法的技术原理、应用场景及局限,结合实验与理论分析提出综合策略,实现多任务增量下的知识保留与性能提升。本研究为视觉模型在动态、长期学习环境中 个人简介:张世周,西北工业大学计算机学院长聘副教授、博士生导师,入选陕西省科技新星及校“翱翔新星”计划。他于西安交通大学获学士与博士学位。研究方向为计算机视觉与图像处理,重点致力于研发自主进化学习方法并应用于无人机视觉任务和空地协同视觉感知任务,以提升无人机视觉感知能力。他在IEEE TPAMI、CVPR、NeurIPS等顶级期刊会议上发表论文60余篇,其中第一/通讯作者30余篇,获 ACM MM HCMA 2023与JCRAI 2025最佳论文奖,并有2篇入选高被引论文。其研究受到CMU、ETH、Meta AI等多国知名团队引用。主持国家自然基金等项目,研究成果已成功应用于多型号无人机系统。
 4
论坛联系人
姓名:程 德
单位和职称:西安电子科技大学副教授
邮箱:dcheng@xidian.edu.cn
姓名:张世周 单位和职称:西北工业大学副教授 邮箱:szzhang@nwpu.edu.cn

