

蚂蚁集团起步于2004年诞生的支付宝,源于一份为社会解决信任问题的初心,经过近二十年的发展,已成为世界领先的互联网开放平台。
我们通过科技创新,助力合作伙伴,为消费者和小微企业提供普惠便捷的数字生活及数字金融服务;持续开放产品与技术,助力企业的数字化升级与协作;在全球广泛合作,服务当地商家和消费者实现“全球收”、“全球付”和“全球汇”。
数字支付
我们致力于数字支付开放平台的建设和发展。基于电脑、手机和IoT智能设备,研发了快捷支付、条码支付、刷脸支付、二维码支付等创新支付技术,服务于商业经营、便民缴费、交通出行等不同场景下的数字支付需求。
数字互联
我们致力于通过开放数字化产品、技术接口和平台资源,助力商家机构数智化转型,助力实体企业经营降本提效、可持续发展。支付宝为超过1.2万家数字化服务商提供智能产品和服务接口,联合他们,助力商家、机构通过小程序、生活号、智能体等经营阵地及辅助经营工具进行数智化经营,并通过支付宝APP为数亿消费者提供便捷丰富的生活服务,助力服务业数智化转型。
数字金融
我们通过技术、数据和平台能力,服务全国超过2000家金融机构,一起为消费者和小微商家提供小微信贷、消费金融、理财、保险等普惠金融服务;并推出了蚂蚁保、蚂蚁财富,以及花呗、借呗等信用购、信用贷类服务。
数字科技
我们持续推动数字科技的创新与应用,在区块链、隐私计算、安全科技、分布式数据库等领域,不断研发蚂蚁链、OceanBase、蚁盾、SOFAStack、mPaaS等领先的科技产品。同时,持续将自身产品与服务,向行业与社会全面开放,携手各方为中小金融机构的数字化升级、服务业小微商家的数字化经营、产业链的数字化协作贡献力量。
全球化
我们通过分享前沿的移动支付技术,逐步和全球合作伙伴共建开放共赢的全球数字普惠生态。从提升中国人的跨境支付体验,到助力解决亚洲用户跨境支付难题;从帮助中国商家更快更好地出海经营,到实现全球商家一次性接入多种数字支付方式、连接全球消费者。
一个 Omni 模型,四种角色:全模态 AI 如何实现自主看图、修图、评图、写文
一、一张旅行照片的全自动进化之旅
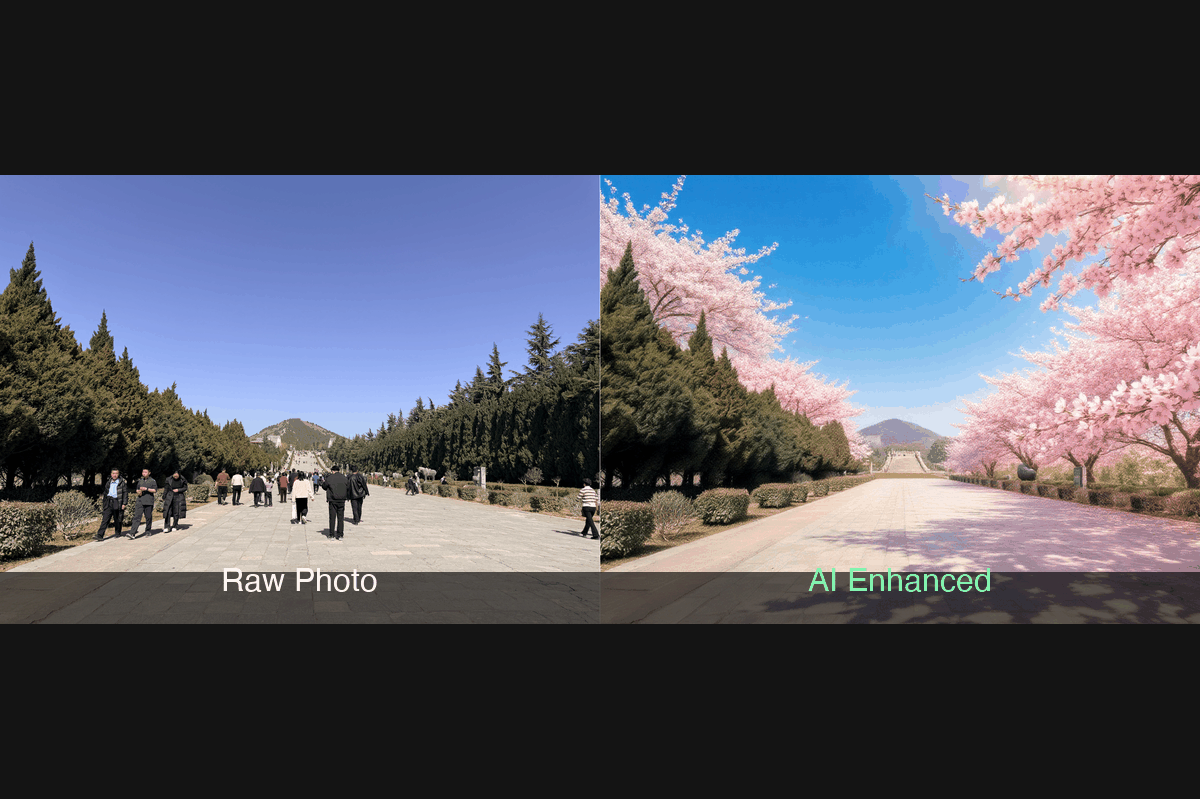
你拍了一组华山的照片,准备发社交媒体。但照片里有些遗憾:前景有游客抢镜,远处有铁栏杆碍眼,整体色调也平淡了些。
传统做法:打开 Photoshop,花半小时逐张修图,再想文案。
而现在,你只需要把照片丢进一个文件夹,告诉agent优化图片,或者执行一条命令:python3 campaign.py run
几分钟后,文件夹里多了对比图、GIF 展示动图,和一段写好的推文文案。全程零人工干预。
这背后不是一套复杂的多模型编排系统,而是一个 Omni 全模态模型——Ming-flash-omni-2.0——同时扮演了四种截然不同的角色。
二、四位一体:一个模型的四种人格
这个项目最值得深入理解的一点是:完成整条流水线的理解、编辑、评价、写作四项任务,用的是同一个模型、同一套 API,区别仅在于 Prompt 和一个输出参数。
Ming-flash-omni-2.0 · 四种角色 | 视觉理解 (Director) | 图片编辑 (Creator) | 质量评价 (Critic) | 文案创作 (Tweet Writer) |
模态转换 | 图 → 文 | 图+文 → 图 | 图+图+文 → 文 | 图+文 → 文 |
典型 Prompt | "图里有哪些干扰物?" | "把行人擦掉,填上背景" | "对比原图和编辑图,打分0-100" | "看这张对比图,写一段推文" |
传统方案要实现同样的能力,至少需要:
1.一个目标检测模型(识别干扰物)
2.一个图像修复/编辑模型(inpaint + 风格迁移)
3.一个图像质量评估模型(IQA)
4.一个语言模型(写文案)
四个模型、四套推理服务、四种数据格式。而 Omni 模型的"全模态"能力,让这一切收敛到同一个 API 调用,只需切换 response_modalities 参数:
# 理解模式:输出文字(用于分析、评分)
config = types.GenerateContentConfig(response_modalities=["TEXT"])
# 编辑模式:输出图片(用于生图、修图)
config = types.GenerateContentConfig(response_modalities=["TEXT", "IMAGE"])
一参之差,能力切换。这就是"全模态"三个字的技术含义。
三、全流程深度拆解
3.1 完整流程图
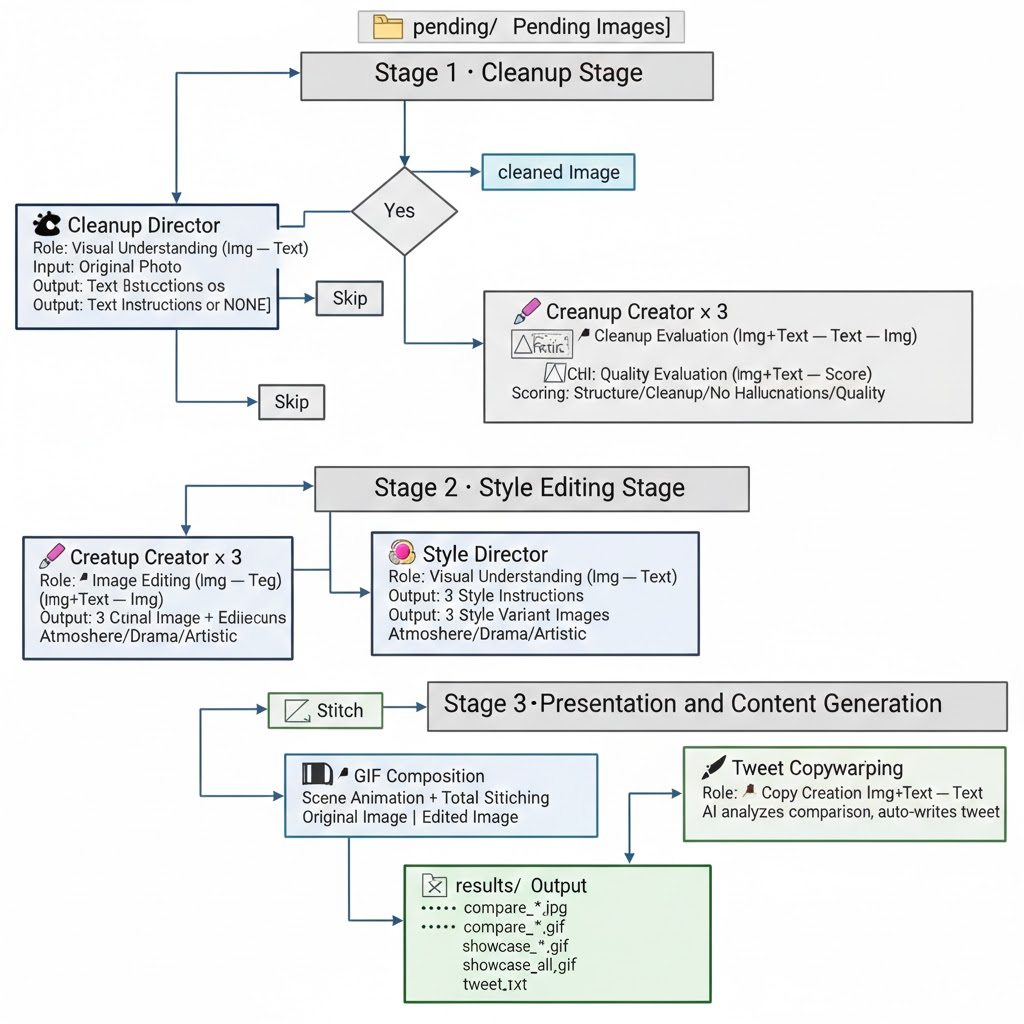
下面是整个图片处理流水线的系统架构流转图:
3.2 角色一:视觉理解——AI "看出"问题所在
analyze_cleanup() 让模型扮演专业修图师,扫描全图找干扰物:
resp = client.models.generate_content( model="inclusionai/ming-flash-omni-2.0", contents=[
types.Part.from_bytes(data=image_data, mime_type="image/jpeg"),
"You are an expert photo retoucher. "
"Scan the ENTIRE image — foreground, midground, background, edges, corners.\n"
"Look for: People, vehicles, barriers, traffic signs, wires...\n"
"DO NOT list: lanterns, cultural ornaments, mountains, trees...\n"
"Return ONE cleanup instruction or NONE."
],
config=types.GenerateContentConfig(response_modalities=["TEXT"])
)
3.3 角色二:图片编辑——AI "动手"修图
注意 response_modalities=["TEXT", "IMAGE"]——这就是从"理解模式"切换到"编辑模式"的唯一区别。模型接收一张图和一段文字指令,直接输出编辑后的新图片。
3.4 角色三:质量评价——AI "审视"自己的作品
AI 生图有一个众所周知的问题:同样的指令,每次生成质量参差不齐。系统的解决方案是"生成多个,让 AI 自己挑最好的"。
3.5 角色四:文案创作——AI 为自己的作品写推文
最后一步,模型再次切换角色,变成社媒文案写手,根据对比图自动识别场景。
四、从单点能力到自主 Agent:Skill 封装与接入
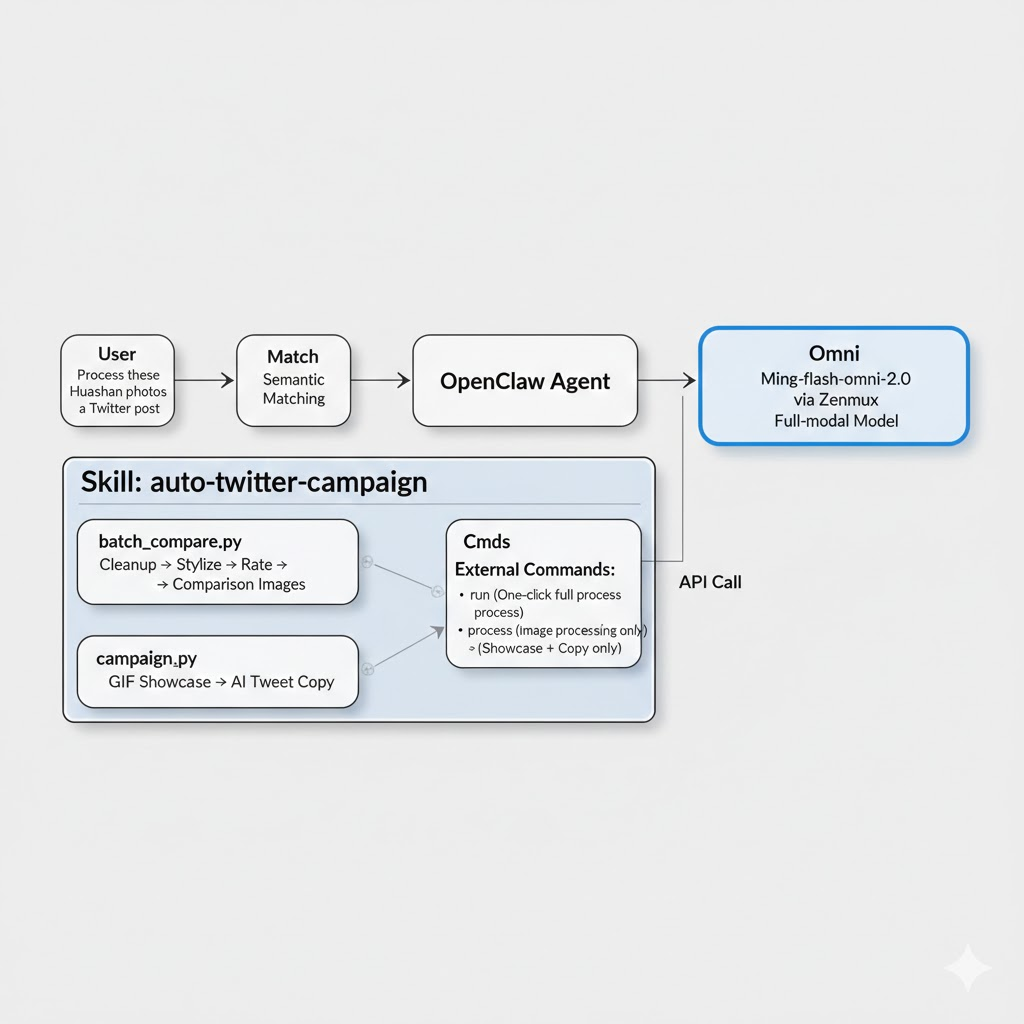
4.1 将完整流水线封装为一个 Skill
在 OpenClaw Agent 框架中,我们将整条自主图片编辑流水线封装为一个 Skill——auto-twitter-campaign:
4.2 Skill 是怎么被 Agent 发现和调用的?
每个 Skill 通过一个 SKILL.md 文件自描述,Agent 通过它理解何时、如何调用。这意味着模型的全模态能力被封装进一个自描述的 Skill,Agent 按需调用,用户只需说一句话。
1 ---
2 name: auto-twitter-campaign
3 description: Autonomous AI image campaign content generator. Processes pending photos via Ming-flash-omni-2.0 (cleanup + style editing), creates side-by-side comparison images and GIF showcases, then auto-generates tweet text using AI. Use for requests like "run campaign", "process pending images", "generate tweet content", or "create showcase from results".
4 ---
5
6 # Auto Twitter Campaign — Content Generator
7
8 Autonomous closed-loop image editing and tweet content generation pipeline.
9 No auto-posting — outputs ready-to-use tweet text + media files.
10
11 ## Quick Start
12
13 ```bash
14 # Full pipeline: process pending images → comparisons → GIFs → tweet text
15 python3 {baseDir}/scripts/campaign.py run
16
17 # Process pending images only (cleanup + style editing → comparison images)
18 python3 {baseDir}/scripts/campaign.py process
19
20 # Generate showcase GIFs + tweet text from existing comparison images in results/
21 python3 {baseDir}/scripts/campaign.py showcase
22
23 # Process a specific image
24 python3 {baseDir}/scripts/campaign.py process --image/path/to/photo.jpg
25
26 # Provide a scene description for better tweet text (otherwise AI auto-describes)
27 python3 {baseDir}/scripts/campaign.py showcase --description "大年初一华山,下棋亭、西峰和南峰"
28 ```
29
30 ## Requirements
31
32 - `ZENMUX_API_KEY` environment variable set
33 - `google-genai` and `Pillow` Python packages
34
35 ## Directories
36
37 - Pending images: `~/campaign_images/pending/`
38 - Candidates (intermediate edits): `~/campaign_images/candidates/`
39 - Results (comparisons, GIFs, tweet text): `~/campaign_images/results/`
40
41 ## Pipeline
42
43 1. **Cleanup Director** — Vision scans for distractions (tourists, vehicles, clutter), generates cleanup instruction
44 2. **Cleanup Creator** — Generates multiple cleanup candidates, critic picks the best
45 3. **Style Director** — Generates 3 style instructions (atmosphere, dramatic, artistic)
46 4. **Style Creator** — Applies each style to the cleaned image, saves comparison images
47 5. **Showcase** — Creates per-scene and all-in-one GIF showcases from comparison images
48 6. **Tweet Writer** — AI analyzes comparison images + description, generates concise tweet text
49
50 ## Output
51
52 After running, `~/campaign_images/results/` will contain:
53 - `compare_*.jpg` — Side-by-side comparison images (original | edited)
54 - `compare_*.gif` — Per-scene animated GIFs cycling through style variants
55 - `showcase_all.gif` — Combined showcase GIF of all comparisons
56 - `tweet.txt` — AI-generated tweet text ready to copy-paste
57 - `description.txt` — Scene description (user-provided or auto-generated)
五、全模态模型对 AI 应用架构的启示
回顾整个项目,这背后有几个值得思考的趋势:
1.从"多模型编排"到"单模型多角色":架构复杂度大幅降低。
2.语义与像素的闭环:理解与生成的深度耦合。在 Omni 架构中,理解(Director)与生成(Creator)不再是两个独立的环节,而是同一个语义空间的两种表达方式。模型能“深刻读懂”华山的险峻(语义理解),本质上是在构建修图所需的空间逻辑;它在修图时能精准补全背景(像素生成),则是对这种语义逻辑的视觉兑现。这种“知行合一”的能力,让 AI 从简单的绘图工具演变为具有认知能力的创作主体。
3."自我评价"能力让 Agent 闭环成为可能:模型能评价自己的作品,使得自主挑选最佳的闭环成立。
4.Skill 封装让模型能力流动起来:从"能力"变成"服务",变成可复用的积木。
本文涉及的项目基于 Ming-flash-omni-2.0 全模态模型,通过 Zenmux API 调用,Skill 接入基于 OpenClaw Agent 框架。完整代码包含在 scripts/batch_compare.py 和 scripts/campaign.py 中。
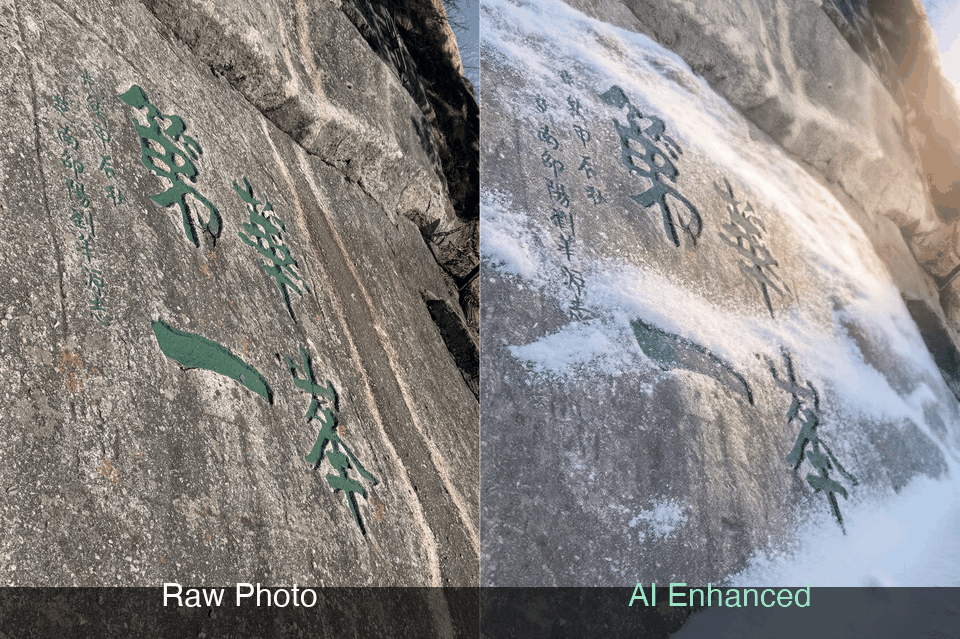
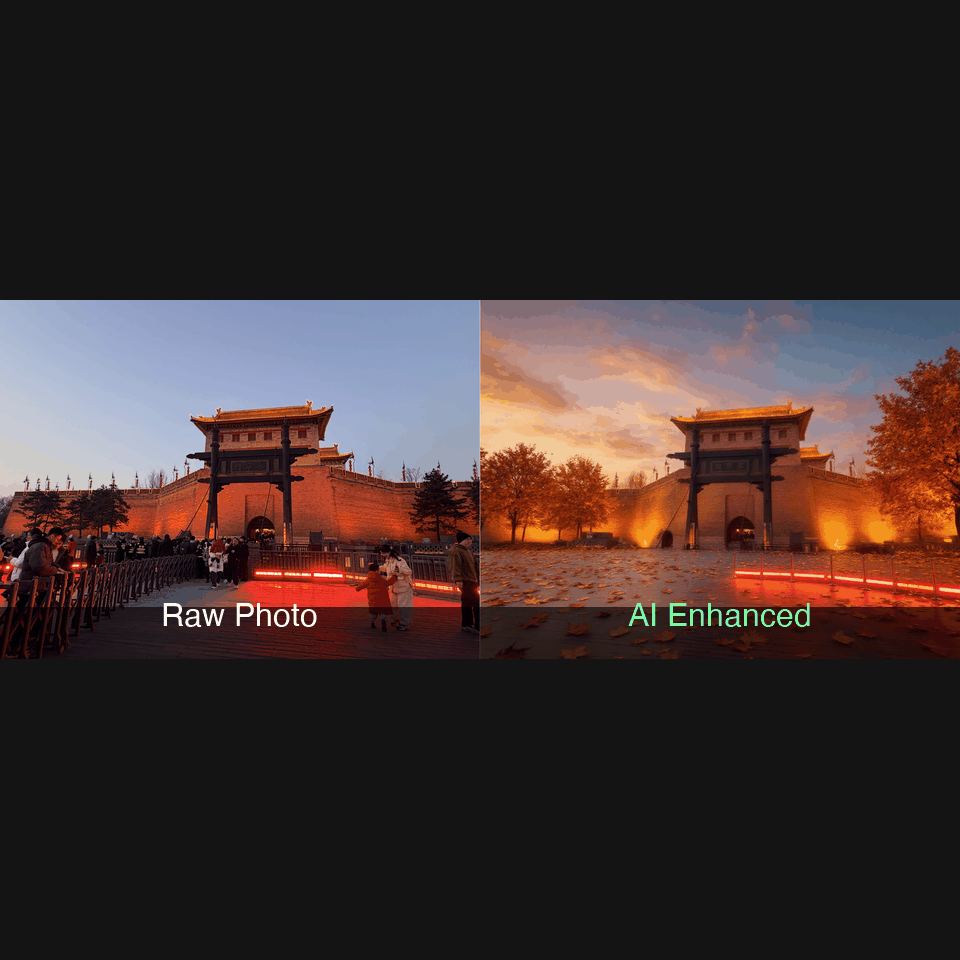
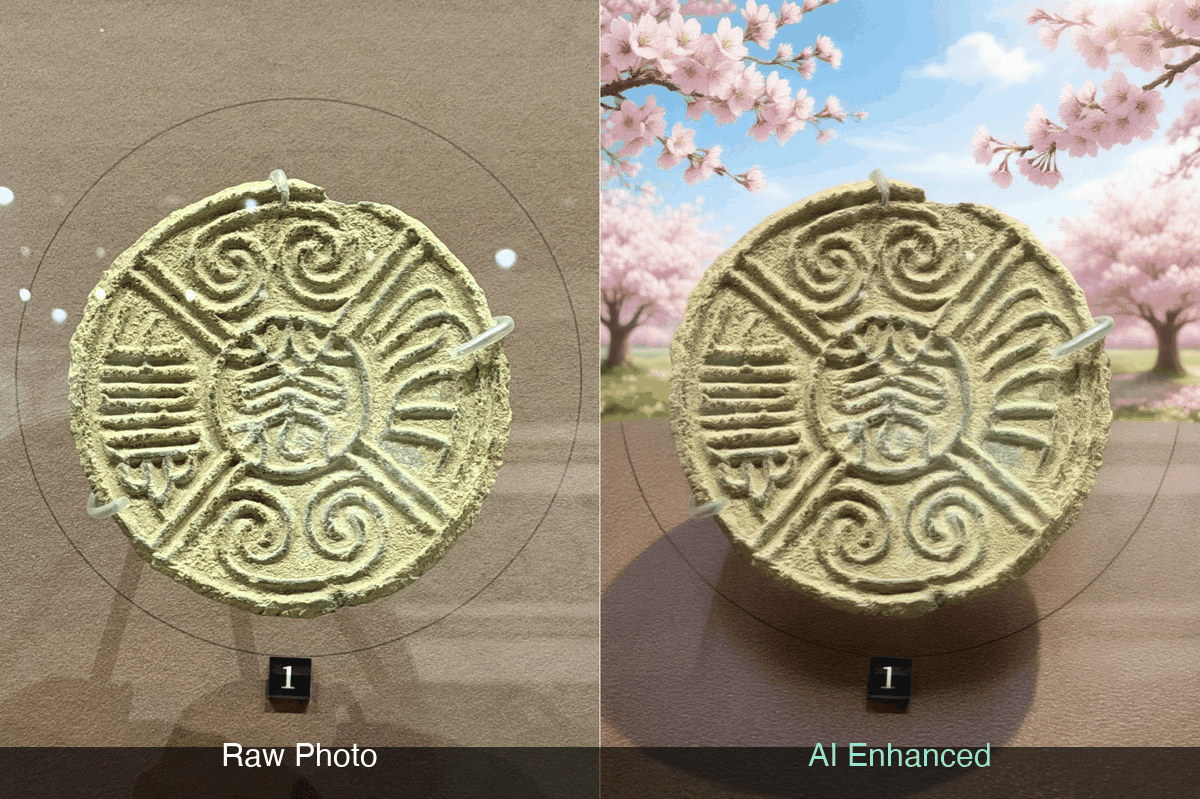
六、真实效果
华山
西安城墙&西安博物院
咸阳宫&陕历博秦汉馆
唐乾陵
skill代码已开源:https://github.com/forde450/agent-skills-report
Ming-Flash-Omni 2.0的技术介绍
【技术先进性】
● 首创桥接式生成-理解统一架构:设计轻量、可插拔的协同架构,在不修改主干理解模型的前提下,高效连接视觉/音频生成模块。该方案成功从 Ming-Lite-Uni 验证→集成至 Ming-Lite-Omni→规模化至 Ming-Flash-Omni(100B MoE),全模态理解和生成评测指标均达到同等尺寸模型领先水平,验证了桥接范式在超大规模模型中的高效性与可扩展性。
● AnyExperts + Multi-Router 跨模态融合:提出按需激活专家机制,实现音视频图文协同训练,相关论文被 AAAI 2026、CVPR 2026 录用。
● 自研连续统一 Tokenizer(MingTok-Vision / MingTok-Audio): 区别于行业常规离散 Tokenizer,发现使用相同的建模范式可以统一图像和语音的理解侧和生成侧表征:MingTok-Vision实现图像重建rFID=0.38,图像理解与业内专用理解模型持平,图像生成效果领先(GenEval 0.85);MingTok-Audio 实现音频重建质量 PESQ=4.2、音色相似度 SIM=0.96;语音理解与生成效果领先(Context ASR 7/12 子项最优,Seed-TTS-ZH WER=0.95)。
● 首创"生成式感知"统一目标:将指代分割与图像编辑统一为同一任务目标,证明生成式模型不仅能匹敌专用感知模型,更在分割任务上超越 SAM、感知能力提升 +350%,并在图像生成(GenEval 0.94)、图像编辑(GEdit 7.7)、指代分割(RefCOCO 72.1)三项任务上全面超越 Qwen-VL、Gemini 1.5 等 SOTA;以多尺度 learnable query token 实现理解对生成的增强,提升了细粒度生成控制能力,生成指标超越metaquery 10+,无损理解能力同时,验证了可插拔架构在生成上的scalling能力。
● 连续自回归语音合成:基于简洁的自回归架构,首次实现 speech/audio/music 泛音频统一生成,在一句话音色克隆中支持方言(粤语96%、四川话86%准确率)、情感(CV3-Eval Emotional avg acc 78%,超CosyVoice3)、语速/语调/音量细粒度控制,以及长播客生成和数学/化学公式正确朗读。
【技术创新带来的业务突破】
● 首个模态支持上全面对标 GPT-4o 的开源模型:Ming-Lite-Omni 成为开源领域首个支持输入音频/视频/图片/文本、输出文本/图片/语音的全模态理解与生成统一模型。
● 首个千亿参数规模的开源全模态统一大模型:Ming-Flash-Omni 验证了桥接式统一范式在 100B MoE 超大规模模型中的可扩展性,为工业级多模态智能系统提供可扩展路径。
● 已上线灵光 App:显著提升用户对现实世界的感知效率,未来将支持基于音视频的自然多模态对话。
● 赋能 OpenClaw / Claude Code 生态:通过 Ming-Omni API 一键接入生图、语音功能,让 AI Agent 具备看、听、说、画的完整能力。
【科技向善】
● 全面开源:公开全部代码、模型权重与评测基准,包括全球首个自由语音编辑评测集,填补多模态生成-理解协同评估的空白。HuggingFace 同类模型趋势榜单(any-to-any)位列榜首,入选热点论文榜。
● 降低行业技术门槛:开源赋能学术界与工业界共同推进多模态智能基座发展,使中小团队也能基于 Ming 系列构建全模态应用。
招 聘 信 息
蚂蚁基础智能—多模态认知团队简介
在蚂蚁集团各项业务中有丰富的多模态、图像、视频理解与生成的应用场景,例如支付宝生活/财富Tab的视频理解、搜索推荐、保险文档图像理解、网商遥感影像解译等,需要计算机视觉、自然语言处理、多模态多个技术专业领域的持续研发,包括多模态图文基础大模型、AIGC图像视频生成模型、通用遥感基础大模型等。
蚂蚁基础智能团队主要负责蚂蚁集团的通用大模型研发工作,我们提供国内第一梯队的算力资源,致力于建设基于大模型的AGI技术。我们期待同样以实现AGI为目标的您加入,共同推动人工智能技术的发展。多模态认知团队成员包括国内外顶尖高校优秀学者和行业资深技术精英,在CVPR/ICCV/ECCV/ICML/IJCAI/AAAI/SIGIR/ACL/ACM’MM等顶级国际学术会议上发表数十篇论文,并在多项国际竞赛取得优秀成绩。
蚂蚁集团-原生多模态大模型算法专家
职位描述
1. 参与原生多模态大模型研发,包括MoE多模态架构、多模态强化学习框架、多模态长思维链推理能力优化、高质量数据合成、体验优化等。
2. 负责原生多模态大模型高效率预训练,以及后训练探索,支撑多模态输入/输出、复杂任务均衡优化。
职位要求
1. 硕士及以上学历,计算机视觉、语音、模式识别、计算机科学或数学相关专业背景。
2. 具备扎实的代码基础,熟练掌握Python/Tensorflow/PyTorch等。
3. 具备较强的团队合作能力和沟通能力。
加分项:
1. 在多模态/语言大模型、计算机视觉领域在国际顶级会议/期刊发表过高质量论文。
2. 有数学、代码类等大模型优化经验优先。
3. 大模型分布式训练、AI Infra等领域有科研或实践经历。
工作地点:北京、杭州
蚂蚁集团-多模态理解及应用-OCR与复杂文档解析
职位描述
1. 复杂文档结构化解析:专注于复杂文档的深度解析,包括版面分析(Layout Analysis)、公式表格识别(Formula Table Recognition & Reconstruction)、关键信息抽取(Key Information Extraction, KIE)等,将非结构化的文档图像或PDF高效地转换成机器可读的结构化数据。
2. 文档问答(DocVQA)系统构建:研发和迭代文档视觉问答模型,让大模型能够精准理解用户的自然语言提问,并结合视觉与文本信息,从复杂的文档(如研究报告、财务报表、合同、票据等)中定位、抽取并生成结构化答案。
3. 核心OCR能力提升:负责前沿OCR技术的研发与优化,攻克手写体、低质量图像、艺术字、复杂排版等挑战性场景下的文字检测与识别难题,显著提升多模态大模型底层的文字信息获取(Text-in-Image)精度与鲁棒性。
4. 前沿技术探索与创新:紧密跟踪多模态、OCR及文档智能领域的最新研究成果,结合业务需求进行技术预研、方案设计和原型实现,推动技术创新和专利产出。
5. 模型与系统优化:负责构建和完善相关方向的数据集、评测体系和模型训练/推理流程,并与工程团队紧密合作,推动算法模型的性能优化与实际落地。
职位要求
1. 学历背景:计算机科学、人工智能、模式识别、电子工程或相关领域的硕士或博士学位。
2. 从业经验:3年以上在OCR、文档理解或相关计算机视觉处理领域的算法研发经验。
3. 专业技能:精通至少一种主流深度学习框架(如PyTorch、TensorFlow),并具备丰富的模型开发与调优经验;拥有大规模多模态大模型(VLM)的训练、微调或应用经验;在以下至少两个方向有深入研究和实践经验:文字检测/识别、版面分析/KIE、表格识别和文档视觉问答 (DocVQA)。
4. 编程能力:具备出色的Python编程能力和扎实的数据结构与算法基础。
5. 学术能力:对领域内的前沿技术有敏锐的洞察力,有在CVPR, ICCV, ECCV, NeurIPS, ICML, ACL等顶级会议或期刊上发表论文者优先。
工作地点:杭州
蚂蚁集团-图像 / 视频生成算法工程师-AIGC方向
职位描述
1. 负责深度学习、生成式模型在图像与视频生成领域的研发与优化,包括文本生成图像(text-to-image)、文本生成视频(text-to-video)、图像/视频编辑等。
2. 研究并实现前沿的生成模型架构(如 Diffusion Models、GAN、Transformer、NeRF 等)以及多模态融合技术(文本、音频、视频、图像)。 3. 结合业务需求,设计和训练高质量的生成模型,提升生成结果的真实感、美学质量、语义一致性和可控性。
4. 建立数据采集与清洗流程,构建高质量的训练、微调和评估数据集(涵盖图像、视频、多模态)。
5. 设计、实现并维护模型推理服务,包括模型部署、性能优化、成本控制和稳定性保障。
6. 对生成模型的评测指标进行研究和完善,包括自动化评分、用户反馈收集、强化学习奖励函数等。
7. 跟进计算机视觉、生成式AI、多模态领域业界及学术新技术,并快速验证和落地。
职位要求
1. 计算机、人工智能、数学、电子工程等相关专业,本科及以上学历,硕博优先。
2. 精通深度学习理论,熟悉常用框架(如 PyTorch、TensorFlow),能够独立实现和调优深度生成模型。
3. 有 Diffusion Models、GAN、VAE 等生成式建模经验,熟悉 Stable Diffusion、Imagen、DALL·E 或相关开源项目。
4. 熟悉 Transformer 在视觉、视频任务中的应用,如 Vision Transformer、Video Transformer、Latent Diffusion 等。
5. 有多模态任务经验(如文本转图像、文本转视频、视频到视频),掌握 CLIP、BLIP、align 模型等跨模态技术。
6. 具备模型可控性技术经验,例如 ControlNet,LoRA,DreamBooth,条件生成等。
7. 熟悉数据处理与增强方法,能够构建高质量训练数据集。
8. 有云端模型部署经验(如 ONNX、TensorRT、Docker、K8s),熟悉性能优化与成本控制。
9. 具有较强的算法研发能力、问题分析和解决能力,能主动跟进前沿技术并在项目中快速应用。
10. 有竞赛获奖或在计算机视觉 / 多模态生成领域的顶会论文(CVPR、ICCV、ECCV、NeurIPS、SIGGRAPH 等)优先。
加分项:
1. 有实际落地的生成式AI产品经验(例如短视频生成、图像编辑工具、游戏或虚拟人视频生成)。
2. 有国际一流开源社区贡献经历 。
3. 熟悉 RLHF(Human Feedback)和奖励模型在图像/视频生成中的应用。
4. 有美术、摄影、动画、影视后期相关领域的背景,对视觉效果有审美能力
5. 熟悉分布式训练、数据并行/模型并行优化 。
6. 使用过大规模多模态模型(如 GPT-4V、Gemini、LLaVA、Kosmos-2 等)。
工作地点:北京、杭州
蚂蚁集团-多模态大模型算法-coding and agent
职位描述
1. 聚焦多模态大模型代码生成的能力构建。
2. 通过数据和算法的优化创新,实现多模态输入到代码的理解、规划、生成和编辑,推动大模型在编程领域的进步和成熟。
职位要求
基本要求:有大模型的数据构造、预训练、后训练的落地经验。有扎实的数理及工程基础。
具备以下以下任一方向深入探索优化的经验:
1. 在思维链(CoT)、逻辑推理方向有探索优化的经验。
2. 对强化学习(RL)有深入研究和实践经验。
3. 在代码生成方向(AI for coding)有研究实践经验。
4. 有前端或全栈工程开发经验(不限语言),掌握常见前端框架(如React)。
5. 有智能体(AI Agent)开发调优的研究实践经验。
加分项:
1. 对于ai coding有热情。
2. 熟悉大模型代码能力评测标准。
工作地点:杭州
蚂蚁集团-语音交互算法专家-杭州
职位描述
1. 负责语音tokenizer,ASR,TTS、端到端对话等算法及新技术方案的研发,推进语音新技术的突破。
2. 负责可控语音生成、语音对话、情感理解及交互等场景的算法方案设计和研发,同时负责推进整体方案的落地。
3. 负责在大模型技术栈下,新业务场景、新交互形态、新算法应用的调研和探索。
职位要求
1. 本科及以上学历,语音、多模态、机器学习、计算机相关专业,2年以上语音研发工作经验。
2. 熟悉语音识别、语音生成、语音前端、端到端对话等语音算法原理。
3. 有语音交互项目的推进和落地经验,熟悉业界主流的语音系统实现方案。
加分项:
1. 在多模态/语音/语言大模型领域有科研或项目实践经验,在国际顶级会议/期刊发表过高质量论文。
2. 大模型分布式训练、AI Infra等领域有科研或实践经历。
工作地点:杭州
蚂蚁集团-多模态大模型RL及infra技术专家
职位描述
1. 负责大模型分布式训练和推理研发,持续优化提升大模型训练框架(基于 MegatronLM ) ,或推理框架(基于 sglang 或 vllm ) 的性能。
2. 深度参与原生多模态大模型研发,实现基于MoE的多模态大模型架构和训练推理框架协同co-design,实现千亿级模型高效训练。
职位要求
1. 具有至少 2 年以上的AI系统/任务调度/高性能并行计算领域研发经验。
2. 熟悉 Transformer/MoE 等大模型结构原理、分布式调度系统、大模型训练/推理/Agent 系统、高性能软硬件架构等任一领域的专业知识。
3. 熟悉 sglang、vllm、megatron 等训推框架和大规模训推优化、GRPO/PPO/DPO 等 RL 算法、AReaL/veRL/openRLHF 等强化学习框架的优先。
4. 对新技术有强烈好奇心,具备较强的团队合作能力,逻辑思维清晰、沟通表达能力强 。
加分项:
1. 在多模态/语言大模型/计算机视觉领域的国际顶级会议/期刊上发表过高质量论文。
2. 熟悉常见的大模型结构,有多模态大模型实际工程优化经验优先。
工作地点:杭州、北京、上海
蚂蚁集团-多模态交互-3D理解生成统一
职位描述
1. 创新3D空间表征范式:研究三维理解与生成的统一架构,探索具备物理常识的空间表征技术,实现高保真的3D感知与智能交互。
2. 完善数据与评价体系:建立全链路3D数据工程与多维度量化评估标准,支撑空间大模型的持续进化与效能优化。
3. 驱动前沿技术落地:布局3D多模态交互的前瞻性研究,定义并实现下一代3D AI产品的核心技术转化。
职位要求
1. 本科及以上学历,计算机相关专业,3D 视觉或视频生成大模型算法相关工作经验。
2. 熟练掌握计算机视觉领域的基础理论和方法,熟悉 PyTorch 等主流深度学习框架,能够独立实现前沿模型。
3. 有良好的自我学习能力及自驱力,对前沿领域有强探索欲,富有想象力和创造力。
4. 良好的学术调研能力,良好的逻辑和数据分析能力,有高质量论文、开源项目、ACM 竞赛经历、相关学术会议组织的权威比赛获奖经历或落地项目产出者优先。
加分项:
1. 在 3d 多模态大模型领域有科研或项目实践经验。
2. 有计算机视觉及模式识别领域顶会(CVPR/ICCV/ECCV/ICML/NeurIPS/ICLR)或顶刊(TPAMI/IJCV)。
工作地点:杭州
蚂蚁集团-多模态视频理解与交互算法专家
职位描述
1. 研究多模态模型预训练新范式,突破多模态对齐、跨模态推理、多模态数据挖掘和合成、效果评测等关键技术难题。
2. 打造行业领先的算法能力:如视频问答、音视频交互等。
3. 探索视觉理解大模型与音视频交互大模型技术的深度融合路径,构建支持图像、视频、语音多模态理解的通用大模型架构和大规模训练。
4. 支持音视频交互推理加速框架建设,构建完善的音视频交互大模型数据链路,探索和细化不同的音视频交互模型的评估维度、方法和指标,落地评估系统,支撑基础大模型迭代和上线。
5. 关注多模态/NLP/语音等方向的前沿技术,及时将新技术应用到产品中。
职位要求
1. 本科及以上学历,计算机相关专业,2年以上视频算法相关工作经验。
2. 熟练掌握计算机视觉领域的基础理论和方法,熟悉PyTorch等主流深度学习框架,能够独立实现前沿模型。
3. 有良好的自我学习能力及自驱力,对前沿领域有强探索欲,富有想象力和创造力。
4. 良好的学术调研能力,良好的逻辑和数据分析能力,有高质量论文、开源项目、ACM竞赛经历、相关学术会议组织的权威比赛获奖经历或落地项目产出者优先。
加分项:
1. 在多模态/语音/语言大模型领域有科研或项目实践经验,或有大模型分布式训练经验。
2. 有计算机视觉及模式识别领域顶会(CVPR/ICCV/ECCV/ICML/NeurIPS/ICLR)或顶刊(TPAMI/IJCV)。
工作地点:杭州

