

- 多模态感知与智能评测前沿论坛
- 脑机智能技术前沿与应用创新论坛
- 数字艺术与智能叙事创新论坛
- 三维成像与显示技术前沿创新论坛
- 多模态垂域大模型与端侧智能论坛
- 多模态大模型的深度认知推理前沿技术论坛
- 视觉-语音-文字多模态智能感知与交互论坛
- 机器智能前沿论坛:微视觉计算论坛
- 视频图像安全智能化演进:感知推理与对抗论坛
- AI时代下的医学影像计算论坛
- 大模型时代的视觉智能前沿论坛
- 脑启发的全天候环境感知技术与应用论坛
- 大模型泛化的边界:长尾挑战与持续学习论坛
- 仿生感知与智能传感计算论坛
- 动态与不确定环境下的鲁棒视觉智能论坛
- 类脑智能与脑机接口论坛
- 多模态生成与理解统一模型论坛
- 面向具身智能的机器视觉与数据生成论坛
- 迈向All-in-One生成式图像复原论坛
- 多媒体可信分析与隐私计算论坛
- 具身智能手术机器人论坛
- 低质量视觉处理与质量评价论坛
- 医学影像大模型论坛
- 类脑智能与医工交叉论坛
- 面向多智能体交互的社会智能论坛
- 结构化视觉理解论坛
- 空天时空智能视觉及应用论坛
- 复杂场景下基础模型感知理解增强论坛
- 沉浸式智能媒体技术论坛
- 多模态数据的理解与生成论坛
- 多智能体协同交互论坛
- 数字文化遗产与文化智能论坛
- 深度伪造治理技术论坛
- 视觉大模型高效感知与轻量化论坛
- 生成式情感智能论坛
- 多模态交互与智能感知前沿技术论坛
- 遥感智能解译论坛:大模型还是小模型?
- 可信多模态大模型青年论坛
- 开放动态环境下的持续学习与智能演进论坛
- 物理知识引导的高效表征、学习与优化论坛
- 机器感知与智能论坛
- 三维建模生成与具身智能论坛
- 极端成像和处理前沿论坛
- 多模态生成与具身应用前沿技术论坛
- 脑机接口与脑信息智能解码论坛
- 具备物理认知的视觉智能技术前沿论坛
- 多模态视觉与空间智能前沿论坛
论坛简介
随着大语言模型和多模态模型的快速发展,人工智能正从单一模态的信息处理迈向对文本、图像、视频、语音等多模态数据的统一理解与生成。多模态数据蕴含着更丰富的语义结构和时序信息,是实现更高层次智能推理、内容生成与人机协作的关键基础。然而,当前多模态模型在跨模态对齐、因果理解、事实一致性与可解释性等方面仍面临诸多挑战。本论坛以“多模态数据的理解与生成”为主题,汇聚来自计算机视觉及相关交叉领域的专家学者,围绕前沿模型方法、数据集构建、真实应用场景等展开深入交流,旨在促进跨领域思想碰撞,推动多模态智能技术的理论创新与落地应用,为人工智能的发展注入新的动力。
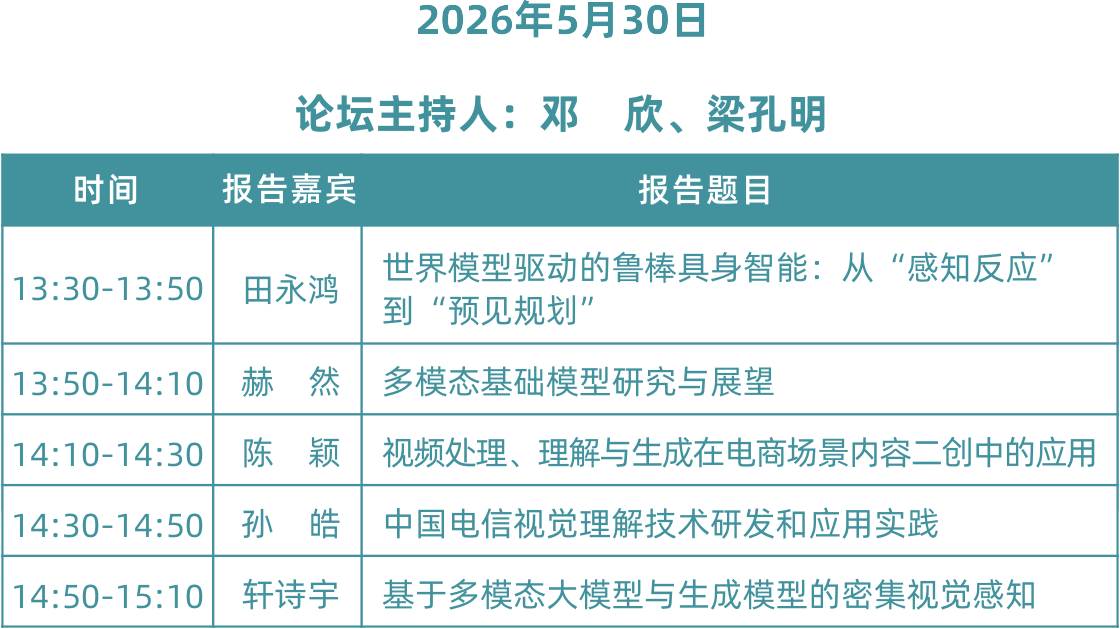
论坛日程
论坛主席
马占宇
CSIG理事
北京邮电大学 教授
个人简介:北京邮电大学人工智能学院教授/博导,党委教师工作部部长、人事处处长、人才办主任,瑞典皇家理工学院博士、博士后,国家杰出青年科学基金获得者,国务院学位委员会智能科学与技术学科评议组成员,教育部高等学校教育技术与人工智能教学指导分委员会秘书长,多模态数据智能感知与治理北京市重点实验室主任,中国图像图形学会青工委副主任、中国人工智能学会副秘书长。主要研究兴趣是人工智能、模式识别与机器学习基础理论与方法,及其在计算机视觉、多媒体信号处理等领域的应用,在包括IEEE TPAMI、CVPR在内的顶级国际期刊和会议上发表论文多篇,担任IEEE TNNLS等国际期刊编委,授权发明专利50余项;先后主持国家自然科学基金委“杰青”、“优青”、联合重点、科技部“科技冬奥”重点研发计划课题等;曾牵头获中国人工智能学会科技进步一等奖、中国图像图形学会技术发明一等奖、国际会议最佳论文奖等;入选“北京市科技新星”计划;获北京市先进工作者、北京高校“优秀共产党员”等荣誉称号。
徐 迈
CSIG理事
北京航空航天大学 教授
个人简介:徐迈,2021年度国家级领军人才特聘教授,北京航空航天大学电子信息工程学院副院长、中国图像图形学会青工委副主任。以第一/通讯作者在IJCV、IEEE TPAMI、JSAC、TIP、TMI、JSTSP、TCSVT等国际顶级期刊及CVPR、ICCV、ECCV、AAAI、DCC、ACM MM等顶级会议上发表论文200余篇(均为SCI/EI检索),其中SCI检索100+篇(JCR1区50+篇,IEEE期刊论文40+篇);18篇论文入选ESI高被引论文/热点论文。获IEEE/ACM国际会议/期刊最佳论文奖6项、提名奖2项。担任图像处理领域顶级期刊IEEE TIP编委(Associate Editor)、IEEE TMM编委(Associate Editor)、信号处理领域权威期刊IEEE J-STSP的首席客座编委(Lead Guest Editor),连续两年获IEEE TMM杰出编委奖。作为负责人承担科研项目20余项,包括国家自然科学基金首批原创探索、重点、优青、面上、青年等项目以及京市杰青等项目。研究成果获2023年度北京市自然科学一等奖(序1)、2020年度教育部技术发明一等奖(序1)、13届中国人工智能学会自然科学一等奖(序1)、24届中国科协求是杰出青年奖。
论坛讲者信息
田永鸿
CSIG理事
北京大学 教授
报告题目:世界模型驱动的鲁棒具身智能:从”感知反应”到“预见规划”
报告摘要:具身智能作为通用人工智能(AGI)向物理世界渗透的关键前沿,其核心挑战在于真实交互数据获取成本极高且长尾场景泛化能力不足,传统的“感知-控制-反应”范式已难以满足复杂任务对鲁棒性的需求。本报告首先深度解析具身智能的演进逻辑及其面临的训练数据瓶颈;随后重点探讨世界模型(World Models)的构建方式,阐述如何通过时空一致性约束与记忆强化机制,构建具备反事实推理能力的高保真环境表征。在此基础上,报告阐述如何构建“世界模型驱动的鲁棒具身智能训练引擎”,通过在虚拟空间内生成大规模、高质量的任务反馈与模拟数据,并结合知识边界抑制生成幻觉,实现从数据驱动向模型驱动的进化范式跃迁,显著提升智能体在开放动态环境下的预见性规划与自主演化效率。
个人简介:田永鸿,北京大学博雅特聘教授,IEEE Fellow,北京大学深圳研究生院副院长兼科学智能学院执行院长,深圳河套学院兼职副院长,鹏城实验室智能计算部副主任兼云脑研究所所长,类脑脉冲大模型北京市重点实验室主任,首批国家杰出青年基金延续资助计划获得者。主要研究方向为分布式机器学习、类脑神经网络、神经形态视觉和AI for Science。累计主持国家重点研发计划、国基金等项目40余项,在Nature/Science子刊、IEEE Trans等期刊/会议发表论文400余篇,拥有美/中国发明专利120余项,获国家二等奖与省部一等奖6项、IEEE标准奖2项、首届祖冲之奖重大成果奖、首届粤港澳大湾区人工智能与机器人奖一等奖、IEEE Hans Karlsson奖等,是首届高校计算机专业优秀教师奖励计划获奖者。
赫 然
CSIG理事
中国科学院自动化研究所 研究员
报告题目:多模态基础模型研究与展望
报告摘要:近年来,多模态大语言模型因其强大的泛化和推理能力,受到了国内外学者以及工业界的广泛关注。本报告将简要回顾多模态大语言模型的发展历程,并围绕多模态大语言模型的数据、评测、架构、训练和应用等方面展开阐述,探讨多模态大语言模型中存在的问题以及未来的发展方向。
个人简介:赫然,中科院自动化所多模态人工智能系统全国重点实验室研究员,IAPR/IEEE Fellow。从事人工智能、模式识别和计算机视觉研究。承担国家青年科学基金ABC类以及北京杰出青年科学基金等项目。在本领域国际主流期刊TPAMI和IJCV上发表论文25篇,第一作者11篇论文引用过百;研究工作获CAAI技术发明一等奖、CSIG自然科学一等奖、北京市科技进步二等奖等。指导学生获得IEEE SPS最佳青年论文奖、ICPR最佳科学论文奖、北京市优秀博士论文、中科院优秀博士论文、IEEE生物特征理事会优秀博士论文。曾/现任CCF-A类权威期刊IEEE TIFS副主编、TIP资深编委、TPAMI\IJCV和自动化学报等国内外期刊编委,以及 NIPS \ ICML \ ICCV \ CVPR \ ECCV \ ICLR \ AAAI \ IJCAI等会议领域主席。
陈 颖
阿里巴巴淘天集团 研究员
报告题目:视频处理、理解与生成在电商场景内容二创中的应用
报告摘要:近年来,随着大语言模型、视觉理解模型以及音视频生成模型等基础模型的迅速发展,AIGC的大规模应用已逐步成为现实。一个精心构建、充分利用多种前沿大模型的音视频生成系统,不仅能够全面提升内容生产效率,还能在视觉呈现上媲美专业剪辑甚至专业拍摄所达到的效果。在电商领域,基于海量直播、短视频及图片素材进行二次创作,已成为一种重要的内容生产方式。通过AIGC技术,商品讲解可以被更加高效、即时、结构化地呈现,从而有效提升用户粘性,促进消费转化。大量由AI生成的二次创作视频,正在成为平台内容生态的重要组成部分,并在电商场景中发挥着越来越关键的作用。本次分享我们将介绍在该领域的实践经验,及背后的算法思考与探索。
个人简介:陈颖,北京大学本硕,芬兰坦佩雷理工大学博士。陈颖2018年加入阿里巴巴,任资深总监(研究员),目前为淘宝音视频技术部门负责人。陈博士2009年加入高通,曾任美国高通首席工程师。之前也分别在诺基亚以及汤姆逊多媒体。陈博士长期深耕多媒体算法与标准,深度参与H.264,H.265以及H.266三代国际视频编码标准制定,曾担任H.264与H.265多视图与3D视频标准规范的联系主编,现任IEEE T-CSVT副编辑。陈博士曾获得2023中国电子学会技术发明一等奖。其研究聚焦视频编码与传输、画质增强与修复、质量评估、视频理解与生成式AI,团队在CVPR NTIRE(含视频质量评价,视频增强与超分)、MSU视频编码等权威赛事中多次夺冠。发表论文100余篇,拥有已授权美国发明专利250余项,Google Scholar引用逾20,000次。
孙 皓
中电信人工智能科技有限公司 研究员
报告题目:中国电信视觉理解技术研发和应用实践
报告摘要:在人工智能技术迅猛发展的当下,视觉理解技术的发展趋势呈现出多元化特点,正在不断重塑各行业的技术生态。中国电信研发的一系列视觉和多模态理解能力,面向大规模应用场景,在基础模型创新、特色能力和产业落地等方面均取得了较大突破。本报告将分享在视觉理解技术研发过程中的思考、探索与实践,以及对未来研究的展望。
个人简介:孙皓,中电信人工智能科技有限公司星辰通用人工智能实验室副主任,视觉理解研发中心负责人,中国电信集团AI首席专家,长期从事计算机视觉、多模态理解和大规模视觉分析系统相关技术研发。牵头打造了中国电信10000+星河算法仓、星辰视觉大模型、星辰多模态理解大模型。主持承担多项国家重大专项课题及任务,担任多所高校研究生企业导师,带领团队获得二十余项国际AI竞赛冠亚军。获评享受政府特殊津贴专家。
轩诗宇
南京理工大学 副教授
报告题目:基于多模态大模型与生成模型的密集视觉感知
报告摘要:多模态大模型与生成式模型在图像理解与内容生成领域取得了突破性进展。然而,如何将这些基础模型的强大逻辑推理能力和丰富的世界知识先验,下沉到细粒度、强空间依赖的密集视觉感知任务中,是当前多模态研究的重要前沿。本次报告将围绕“多模态内容理解与生成”的主题,探讨基于大模型驱动的密集视觉感知新范式。报告将沿着两条核心技术路线展开:一是基于多模态大模型的理解与推理,探讨如何激发大模型的指代理解与空间认知潜能;二是生成先验的逆向应用,探索如何挖掘预训练文生图模型内部丰富的物理世界先验,将其转化为强大的视觉特征表示。报告旨在探索密集视觉感知任务在基础模型加持下向通用范式演进的可能路径。
个人简介:轩诗宇,南京理工大学计算机学院副教授,依托唐金辉教授、李泽超教授领导的智能媒体分析中心。博士毕业于北京大学计算机学院,导师是张史梁教授。主要研究方向是计算机视觉感知与多模态内容理解。主持国家自然科学基金青年基金(C类)、江苏省自然科学青年基金、CCF-百度松果联合基金等项目。近年来在TPAMI、IJCV、CVPR等国际期刊和会议发表学术论文20余篇。担任包括TPAMI、TIP、CVPR、NeurIPS在内的多个国际期刊与会议的审稿人。CSIG-MM专委会、CCF-MM专委会委员,CCF-MM秘书处成员。
论坛联系人
姓名:梁孔明
单位和职称:北京邮电大学副教授
邮箱:liangkongming@bupt.edu.cn
姓名:邓欣
单位和职称:北京航空航天大学教授
邮箱:cindydeng@buaa.edu.cn

