

- 多模态感知与智能评测前沿论坛
- 脑机智能技术前沿与应用创新论坛
- 数字艺术与智能叙事创新论坛
- 三维成像与显示技术前沿创新论坛
- 多模态垂域大模型与端侧智能论坛
- 多模态大模型的深度认知推理前沿技术论坛
- 视觉-语音-文字多模态智能感知与交互论坛
- 机器智能前沿论坛:微视觉计算论坛
- 视频图像安全智能化演进:感知推理与对抗论坛
- AI时代下的医学影像计算论坛
- 大模型时代的视觉智能前沿论坛
- 脑启发的全天候环境感知技术与应用论坛
- 大模型泛化的边界:长尾挑战与持续学习论坛
- 仿生感知与智能传感计算论坛
- 动态与不确定环境下的鲁棒视觉智能论坛
- 类脑智能与脑机接口论坛
- 多模态生成与理解统一模型论坛
- 面向具身智能的机器视觉与数据生成论坛
- 迈向All-in-One生成式图像复原论坛
- 多媒体可信分析与隐私计算论坛
- 具身智能手术机器人论坛
- 低质量视觉处理与质量评价论坛
- 医学影像大模型论坛
- 类脑智能与医工交叉论坛
- 面向多智能体交互的社会智能论坛
- 结构化视觉理解论坛
- 空天时空智能视觉及应用论坛
- 复杂场景下基础模型感知理解增强论坛
- 沉浸式智能媒体技术论坛
- 多模态数据的理解与生成论坛
- 多智能体协同交互论坛
- 数字文化遗产与文化智能论坛
- 深度伪造治理技术论坛
- 视觉大模型高效感知与轻量化论坛
- 生成式情感智能论坛
- 多模态交互与智能感知前沿技术论坛
- 遥感智能解译论坛:大模型还是小模型?
- 可信多模态大模型青年论坛
- 开放动态环境下的持续学习与智能演进论坛
- 物理知识引导的高效表征、学习与优化论坛
- 机器感知与智能论坛
- 三维建模生成与具身智能论坛
- 极端成像和处理前沿论坛
- 多模态生成与具身应用前沿技术论坛
- 脑机接口与脑信息智能解码论坛
- 具备物理认知的视觉智能技术前沿论坛
- 多模态视觉与空间智能前沿论坛
论坛简介
随着人工智能和多媒体技术的快速发展,图像、视频等多媒体内容在各行业中的应用不断深化,但也带来了内容安全、隐私泄露和AI治理等新挑战。深度伪造、内容篡改、数据滥用等安全问题日益突出,亟需高效、可信的多媒体分析与防护技术。同时,如何在保障用户隐私的前提下,实现多媒体数据的智能分析与安全共享,也成为业界关注的热点。隐私计算技术如联邦学习、差分隐私、安全多方计算等为多媒体数据的合规应用提供了新的解决思路。本论坛将聚焦多媒体内容安全、AI治理与隐私计算等前沿议题,探讨多媒体数据伪造检测、隐私保护、模型可信性等关键技术与实践,分享最新研究进展和应用案例。
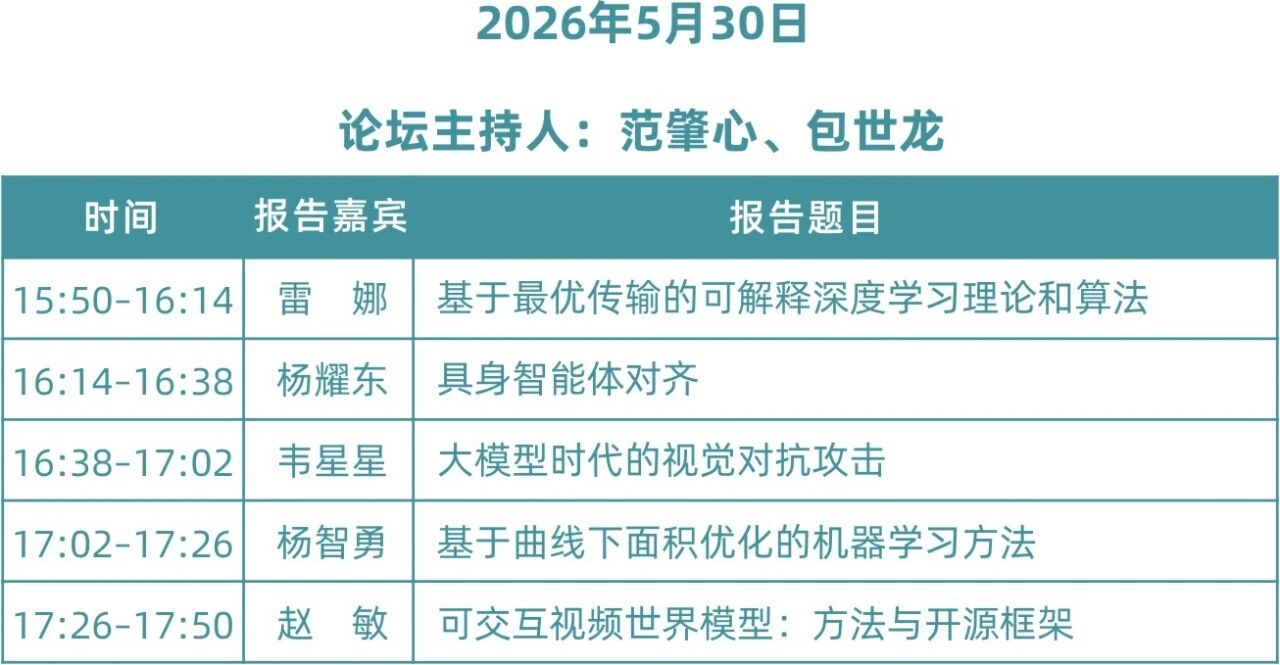
论坛日程
论坛主席
黄庆明
CSIG常务理事
中国科学院大学 教授
个人简介:黄庆明,中国科学院大学讲席教授、博士生导师,国家杰出青年科学基金获得者,百千万人才工程国家级人选并被授予“有突出贡献中青年专家”荣誉称号,享受国务院政府特殊津贴。主要研究方向为多媒体计算、图像与视频分析、模式识别、机器学习、计算机视觉等,主持承担了新一代人工智能国家科技重大专项、国家自然科学基金重点和重点国际合作项目、863课题、973课题、中科院前沿科学重点研究项目等国家和省部级项目的研究工作,已在国内外权威期刊和重要国际会议上发表学术论文600余篇(Google学术引用43000余次,H指数92),其中IEEE/ACM汇刊和中国计算机学会(CCF)认定的A类论文300余篇,申请国内外发明专利70余项(40余项已授权)。相关研究成果获得吴文俊人工智能自然科学一等奖、中国图像图形学会自然科学一等奖、教育部科技进步一等奖等多项国家学会和省部级奖励。
包世龙
中国科学院大学 助理研究员
个人简介:包世龙,中国科学院大学博士后/特别研究助理,北京图象图形学学会青工委委员,研究方向为机器学习与人工智能安全,在 CCF-A 类期刊/会议上发表论文 20余篇 (一作论文7篇),包括TPAMI 9 篇 (IF:18.6,一作4篇)。先后入选中国博士后科学基金国家资助博士后研究人员计划、北京市“高创计划”青年人才托举工程、中国科学院特别研究助理项目等人才支持计划;主持国家自然科学基金青年项目(C类)、中国博士后科学基金面上等项目,并参与中科院先导 B、国家自然科学基金专项等重大项目。
论坛讲者信息
雷 娜
大连理工大学国际信息与软件学院 教授
报告题目:基于最优传输的可解释深度学习理论和算法
报告摘要:最优传输研究如何将给定的概率分布以最低的代价映射到另一个概率分布,它是目前深度学习领域中一个非常火热的研究方向。在这个报告中,我们将首先介绍最优传输的基本理论和相关算法,然后从最优传输的视角来解释生成任务和分类任务,最后我们将介绍基于最优传输构建的能够避免模式崩溃的新型生成模型、长尾分类模型、图像超分辨模型等。
个人简介:雷娜,大连理工大学软件学院、国际信息与软件学院党委书记,教授、博士生导师。研究方向主要聚焦于计算共形几何、计算拓扑、计算机数学算法及其在人工智能、计算机图形学、几何建模和医学图像中的应用。主持国家杰出青年科学基金、国家重点研发计划课题、国家自然科学基金重大项目课题、重点项目以及中央部委创新项目等。学术成果多次被菲尔兹奖获得者和美国科学院院士等在国际会议上介绍;获得的知识产权在工业界转化应用,应用单位评价所开发的软件“综合质量优于商业软件”。曾担任网格生成领域国际顶会IMR三十年来首位来自亚洲committee member。获得世界华人数学家大会最佳论文奖,辽宁省自然科学一等奖,八桂人工智能科学技术一等奖,辽宁省优秀研究生导师团队,兴辽英才计划领军人才,兴连英才等称号。
 、
杨耀东
北京大学人工智能研究院 研究员
报告题目:具身智能体对齐
报告摘要:围绕灵巧操作在真实环境中落地难、稳定性不足等关键问题,本报告聚焦“虚实对齐”这一核心技术路径,系统探讨其在灵巧操作大模型中的方法体系与工程实践。通过构建高保真物理仿真并结合参数随机化,覆盖接触、摩擦与柔顺性等关键物理因素,同时融合基于 UMI/Manus 等遥操作的人类示范数据与多模态感知表征,建立动作—视觉—触觉协同的跨模态对齐机制;在策略学习阶段引入分层控制与约束强化学习,将复杂灵巧操作拆解为具备可迁移性的技能单元,从而有效缩小仿真到真实的差距。基于 VLA(Vision-Language-Action)模型的实验结果表明,将虚实对齐机制嵌入数据采集、模型训练与控制执行的全过程,可显著提升灵巧操作在真实场景中的成功率、泛化能力与安全性,为具身智能由“可演示”迈向“可部署”提供了可行且可扩展的技术路径。
个人简介:杨耀东,北京大学人工智能研究院研究员(博雅学者),北大-灵初智能联合实验室首席科学家。国家人社部高层次留学人才、国家优秀青年科学基金(海外)获得者、中国科协青年托举计划入选者。主要研究方向为智能体交互学习与对齐,致力于大模型的可信应用与安全落地,科研领域涵盖强化学习、AI对齐与具身智能。以独立通讯作者身份发表Nature Machine Intelligence、ACL 2025最佳论文等,谷歌学术引用逾15000+次,自2022年以来位列CSRanking北大人工智能与机器学习方向学者首位,入选Scopus全球Top2%顶尖科学家、福布斯中国年度科创人物、麻省科技评论AI100榜单。曾获气象服务协会技术发明一等奖,吴文俊人工智能科技进步二等奖。
韦星星
北京航空航天大学人工智能学院 教授
报告题目:大模型时代的视觉对抗攻击
报告摘要:随着人工智能深度介入安全攸关场景,智能模型固有的脆弱性为多媒体可信分析带来了严峻挑战。攻击者可通过构造对抗样本诱导模型误判,威胁物理空间安全。因此,深入挖掘大模型时代的感知漏洞,是构建可信多媒体分析体系的核心。本报告重点探讨了大模型时代视觉对抗攻击的三大转变:一是攻击对象由小模型向大模型的转变;二是攻击形式由单模态向多模态的转变;三是攻击环境由白盒向黑盒的转变。针对上述挑战,本报告将介绍“几何对抗攻击(Geometric Adversarial Attack)”新框架。该框架通过优化目标的几何属性来应对上述演变:在姿态维度,通过脆弱姿态挖掘实现“零扰动”攻击,利用目标拓扑缺陷诱导大模型误判;在形状维度,基于形状建模确保攻击在不同波谱成像下具备物理一致性,突破多模态防御;在位置维度,利用敏感位置引导技术锁定几何关键区域,显著增强黑盒迁移效能。
个人简介:韦星星,现为北京航空航天大学人工智能学院教授,博士生导师,国家级青年人才,入选年度全球前2%顶尖科学家榜单。主要研究方向为计算机视觉、安全可信人工智能。在TPAMI, IJCV和CVPR, ICCV等人工智能领域顶级期刊和会议发表学术论文100余篇(其中TPAMI、IJCV论文14篇,ESI高被引论文5篇),授权发明专利20余项(其中2项已经成果转化)。作为负责人主持科技部“新一代人工智能”重大项目课题、国家自然科学基金面上项目(2项)、国防基础科研项目、华为/腾讯校企合作项目。荣获国防技术发明一等奖(序3),在国际顶会举办的重要竞赛中获得冠亚军5项,优秀奖5项。
杨智勇
中国科学院大学计算机科学与技术学院 副教授
报告题目:基于曲线下面积优化的机器学习方法
报告摘要:本报告以物理学第一性原理中的不变量思想为理论出发点,系统介绍所在团队基于曲线下面积优化的机器学习方法体系。正如物理定律不依赖于参考系选择,模型评估亦应独立于判别阈值等人为参数。受此启发,通过性能曲线的面积积分来消除判别参数影响,对传统的ROC曲线及AUC指标进行拓展,形成Xcurve优化框架,实现从参数依赖到判别不变量的转变。围绕这一核心思想,依次汇报XCurve在性能约束、分布漂移及开放环境下等场景中的应用。
个人简介:杨智勇,中国科学院大学副教授,博士生导师,研究方向聚焦可信机器学习。在CCF-A类期刊及会议上发表论文70余篇,其中TPAMI20余篇,一作6篇。获吴文俊人工智能青年科技奖、CCF优秀博士学位论文激励计划、CSIG自然科学奖一等奖、吴文俊人工智能科技进步二等奖、小米青年学者、首届百度AI全球华人新星百强、百度奖学金全球20强,以及CCF-A类会议国际竞赛冠军4项。兼任多个JCR1区期刊编委,以及ICML/ICLR/NeurIPS领域主席。
赵 敏
南京大学 助理教授 报告题目:可交互视频世界模型:方法与开源框架 报告摘要:本报告围绕“长视频生成”与“实时交互”两条主线,介绍近期在视频扩散模型与可交互视频世界模型方向的系列工作。第一部分聚焦视频长度外推:从 RoPE 内在频率分量出发,提出 RIFLEx 与 UltraViCo 等方法,分别首次实现视频扩散 Transformer 的免训练 2× 与 4× 长度外推。第二部分介绍实时可交互视频生成:针对双向扩散模型蒸馏到因果自回归模型中的“结构鸿沟”问题,提出 Causal Forcing,在 Dynamic Degree、VisionReward、Instruction Following 等指标上显著优于 Self Forcing。此外,报告还将介绍首个覆盖数据、训练、蒸馏、推理全流程的 Action-conditioned World Model 开源框架 minWM。最后,报告将结合上述工作,展望可交互视频世界模型的若干前沿方向。 个人简介:赵敏,即将加入南京大学担任助理教授,国产视频生成模型 Vidu 核心作者,入选清华大学“水木学者”计划。研究方向为视频生成与可交互视频世界模型。以第一作者/共同第一作者身份在 NeurIPS、ICML、ICLR 等国际顶级会议发表论文多篇,一作论文引用700余次,累计引用1000余次。提出的视频长度外推方法 RIFLEx 及实时交互生成方法 casual forcing 等,已被 HunyuanVideo、CogVideoX 等主流开源视频扩散框架集成应用,主导相关开源项目累计获得 GitHub Star 近3000次。
论坛联系人
姓名:范肇心
单位和职称:北京航空航天大学助理教授
邮箱:zhaoxinf@buaa.edu.cn
姓名:包世龙
单位和职称:中国科学院大学助理研究员
邮箱:baoshilong@ucas.ac.cn

