

- 多模态感知与智能评测前沿论坛
- 脑机智能技术前沿与应用创新论坛
- 数字艺术与智能叙事创新论坛
- 三维成像与显示技术前沿创新论坛
- 多模态垂域大模型与端侧智能论坛
- 多模态大模型的深度认知推理前沿技术论坛
- 视觉-语音-文字多模态智能感知与交互论坛
- 机器智能前沿论坛:微视觉计算论坛
- 视频图像安全智能化演进:感知推理与对抗论坛
- AI时代下的医学影像计算论坛
- 大模型时代的视觉智能前沿论坛
- 脑启发的全天候环境感知技术与应用论坛
- 大模型泛化的边界:长尾挑战与持续学习论坛
- 仿生感知与智能传感计算论坛
- 动态与不确定环境下的鲁棒视觉智能论坛
- 类脑智能与脑机接口论坛
- 多模态生成与理解统一模型论坛
- 面向具身智能的机器视觉与数据生成论坛
- 迈向All-in-One生成式图像复原论坛
- 多媒体可信分析与隐私计算论坛
- 具身智能手术机器人论坛
- 低质量视觉处理与质量评价论坛
- 医学影像大模型论坛
- 类脑智能与医工交叉论坛
- 面向多智能体交互的社会智能论坛
- 结构化视觉理解论坛
- 空天时空智能视觉及应用论坛
- 复杂场景下基础模型感知理解增强论坛
- 沉浸式智能媒体技术论坛
- 多模态数据的理解与生成论坛
- 多智能体协同交互论坛
- 数字文化遗产与文化智能论坛
- 深度伪造治理技术论坛
- 视觉大模型高效感知与轻量化论坛
- 生成式情感智能论坛
- 多模态交互与智能感知前沿技术论坛
- 遥感智能解译论坛:大模型还是小模型?
- 可信多模态大模型青年论坛
- 开放动态环境下的持续学习与智能演进论坛
- 物理知识引导的高效表征、学习与优化论坛
- 机器感知与智能论坛
- 三维建模生成与具身智能论坛
- 极端成像和处理前沿论坛
- 多模态生成与具身应用前沿技术论坛
- 脑机接口与脑信息智能解码论坛
- 具备物理认知的视觉智能技术前沿论坛
- 多模态视觉与空间智能前沿论坛
论坛简介
近年来,大模型在语言、视觉、语音等单一模态上取得突破性进展,但现实世界的信息天然呈现为多模态与强关联形态,单一模态建模已难以支撑复杂智能任务。多模态理解模型在感知与推理方面表现突出,而多模态生成模型在内容创作与交互方面展现潜力,但二者长期分离,存在表示割裂、能力难以迁移等问题。推动多模态生成与理解的统一建模,已成为构建通用智能的重要方向。本论坛聚焦多模态生成与理解统一模型的理论基础、模型架构等,探讨如何在统一表示空间中兼顾语义理解、内容生成与跨模态对齐能力,推动模型从“任务特化”迈向“能力统一”。通过汇聚学术界与产业界的前沿成果,推动多模态基础模型向更高效、更可靠、更具泛化能力的方向发展。
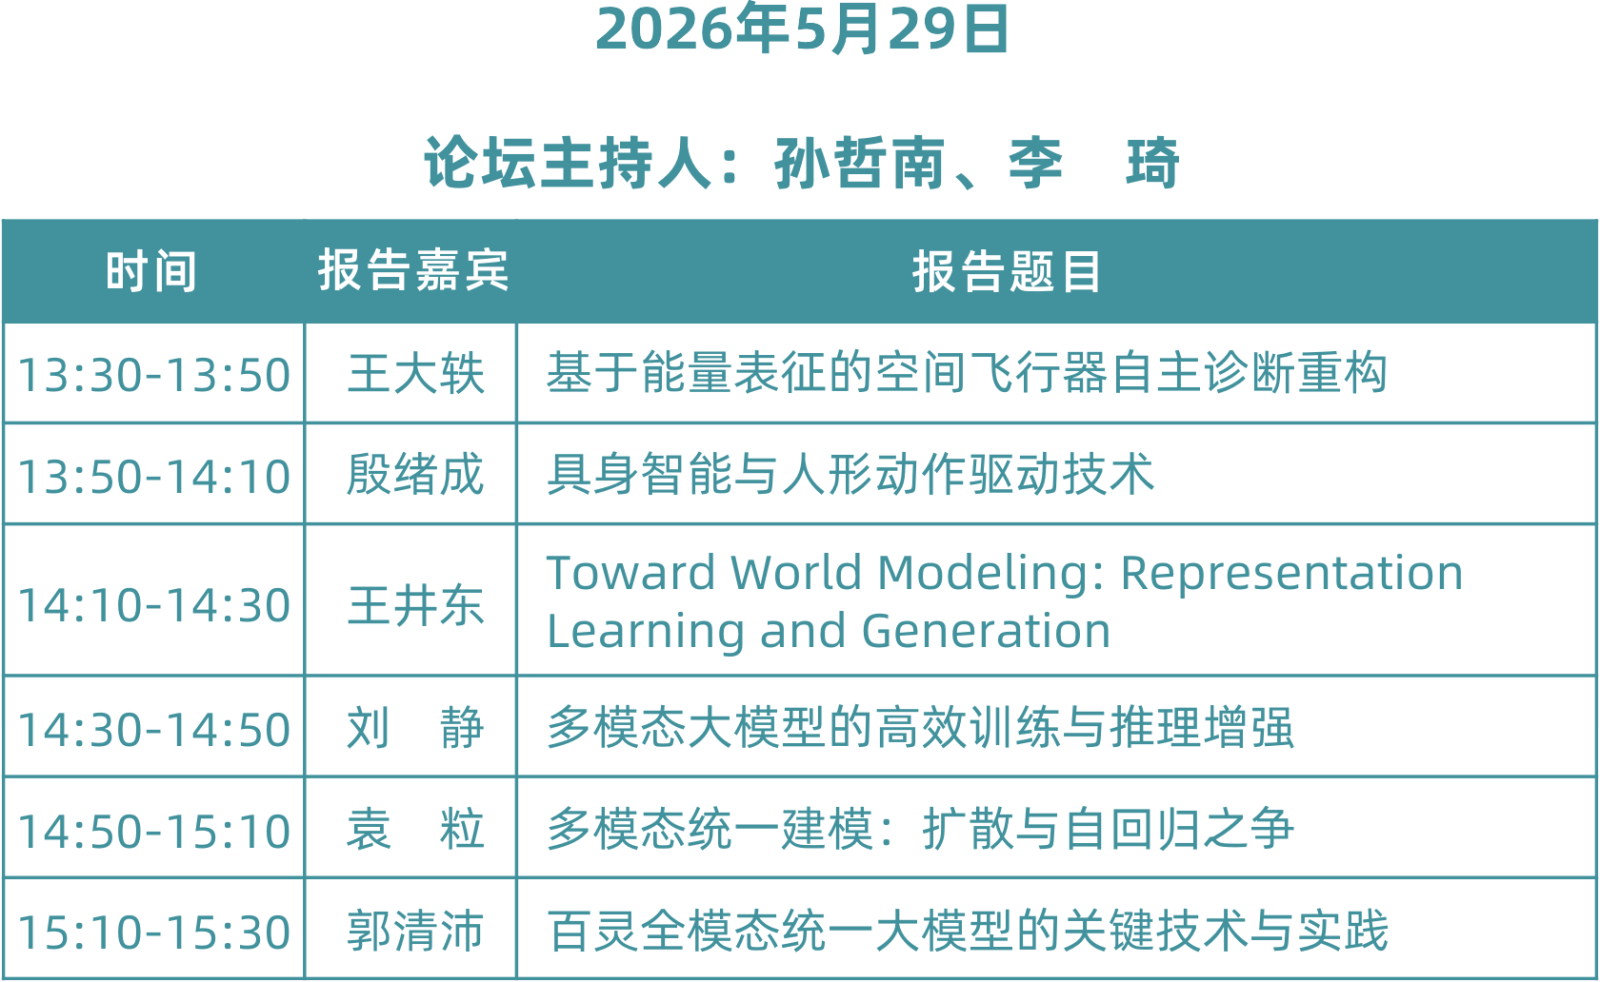
论坛日程
论坛主席
孙哲南
CSIG理事
中国科学院自动化研究所 研究员
个人简介:孙哲南,中国科学院自动化研究所研究员和博士生导师、中国科学院大学人工智能学院岗位教授、国际模式识别学会IAPR Fellow和IAPR生物特征识别技术委员会主席。主要研究方向计算机视觉和模式识别,主持4项国家自然科学基金委重点和面上项目,以及3项国家重点研发计划项目和课题,发表国际期刊和会议论文300多篇,获得超过24000次Google学术引用,H因子58,授权发明专利56项。科研成果获得国家技术发明二等奖、中国专利优秀奖,入选国家万人计划科技创新领军人才和科技部中青年科技创新领军人才。
李 琦
中国科学院自动化研究所 研究员
个人简介:李琦,中国科学院自动化研究所研究员,中国科学院青促会会员,中国科学院特聘研究骨干,北京市科协青年人才托举,中国图像图形学会生物特征识别专委会秘书长。共发表高水平期刊和会议文章80多篇,代表作AnyFace被评选为CVPR最佳论文候选,并入选TPAMI专刊Best of CVPR。撰写Springer专著1部。申请人多次担任国内生物特征识别旗舰会议CCBR程序委员会主席、出版主席等,担任ICLR 2025/2026领域主席。主持国家重点研发计划青年科学家项目一项,科技创新2030“新一代人工智能”重大项目课题一项,国家自然科学基金两项。研究工作曾获北京市科技进步奖一等奖(排序2/15)、中国图像图形学会自然科学奖二等奖、技术发明奖二等奖等。
论坛讲者信息
王大轶
北京空间飞行器总体设计部 研究员
报告题目:基于能力定量表征的序列图像自主导航
报告摘要:空间飞行器作为典型的无人系统对自主运行提出了迫切需求,而自主导航是其中的关键核心。针对资源强受限的空间飞行器,报告人提出了一类二阶动态系统观测能力定量表征理论方法,以及基于能力定量表征的自主导航技术,实现了理论发展、方法创新、技术突破与工程应用的完整闭环,为我国深空探测等任务的顺利完成做出重要贡献。
个人简介:王大轶,研究员,北京空间飞行器总体设计部 科技委主任,是国家杰青、国防卓青、万人领军,973项目技术首席专家、政府特殊津贴专家。长期从事观测、诊断和重构能力定量表征理论方法以及空间飞行器自主运行技术研究,入选国家自然科学基金十三五优秀成果,为我国深空探测、北斗三号等任务成功做出重要贡献。获首届国家卓越工程师奖、国家技术发明二等奖、国家科技进步特等奖、何梁何利基金科技创新奖、全国创新争先奖、钱学森杰出贡献奖等,是国家有突出贡献中青年专家。
殷绪成
CSIG常务理事
北京科技大学 教授
报告题目:具身智能与人形动作驱动技术
报告摘要:赋予人形机器人自然的肢体表达能力,是具身智能迈向真实世界的核心任务之一。我们针对交互动作生成与实机驱动展开系列研究:构建了兼顾保真度与推理速度的高效扩散动作合成框架;建立了面向角色与场景的大规模全身动作数据集;将生成范式从被动文本驱动推进到主动交互感知,使模型自主判断动作时机与空间朝向;最后通过稳定性约束与自适应强化学习协调表达力与平衡性,弥合运动学生成与双足物理执行间的鸿沟。本系列工作为人形机器人在自然人机交互、智能导览等服务场景的落地提供了系统性技术支撑。
个人简介:殷绪成,教授、博导,国家杰出青年科学基金项目获得者、科技创新2030——“新一代人工智能”重大项目首席科学家,北京科技大学计算机与通信工程学院院长、模式识别与人工智能技术创新实验室主任,中国图像图形学会文档图像分析与识别专委会主任。主要研究领域包括模式识别、文字识别、计算机视觉、工业智能与工业软件技术及应用,在中国计算机学会推荐国际期刊和会议上发表论文一百多篇,曾获北京市科技进步一等奖、中国电子学会科技进步一等奖、吴文俊人工智能奖技术发明一等奖。
王井东
CSIG理事
百度 研究员
报告题目:Toward World Modeling: Representation Learning and Generation
报告摘要:世界模型通常需要表达世界并且预测未来。主流的方案包含表征学习和生成等子任务。本报告讲述其中底层算法在表征学习和生成方面的工作。在表征学习方面,简单回顾自监督表征学习方法Context Autoencoder (IJCV),其核心思想是在表征空间完成任务,与Yann LuCun 的关于世界模型的工作JEPA思想一样,我们发表更早,其中提出的attentive probing方案也被广泛应用。在表征生成方面,主要介绍在flow matching训练方面的工作,包括self-representation alignment(SRA ICLR 2026, SRA 2 CVPR 2026)和MixFlow(CVPR 2026),其中SRA工作被Black Forest Labs(Flux)推广并应用到大规模多模态生成中。
个人简介:王井东,博士,加拿大工程院外籍院士、国际电气电子工程师学会会士、国际模式识别学会会士、国际计算机协会杰出会员。加入百度之前,从2007年至2021年在微软亚洲研究院担任研究员。目前研究领域包括世界模型、多模态理解和生成以及扩散模型等。 以前的研究领域主要为:计算机视觉、深度学习和多媒体搜索,代表工作包括:第一个统一的视觉识别网络 - 高分辨率网络HRNet、 第一个基于Transformer query的图像语义分割网络OCRNet和第一个基于近邻图的实用的大规模向量搜索算法SPTAG。
王井东博士担任ICCV 2025程序委员会主席,担任或曾担任IEEE TPAMI、IJCV、ACM TOMM、IEEE TMM和IEEE TCSVT编委, 担任或曾担任视觉、机器学习、多媒体等人工智能方向顶会的(资深)领域主席。
刘 静
中国科学院自动化研究所 研究员
报告题目:多模态大模型的高效训练与推理增强
报告摘要:随着多模态大模型(MLLMs)在诸多感知任务上趋近性能瓶颈,其沉重的计算负担与落地成本已成为制约其迈向通用人工智能的关键壁垒。本报告聚焦“快训推”与“强推理” 的两个核心问题,旨在探讨如何在有限的计算资源下,实现多模态大模型的高效计算,进一步增强其核心的深度推理能力。我们将系统阐述从模型架构设计、训推策略到后训练增强等方面,为实现低成本、高性能的多模态认知智能提供技术路径与实践洞察。另外,还将简单介绍团队在相关方向的最新研究成果,并展望未来发展方向与潜在挑战。
个人简介:刘静,中国科学院自动化研究所研究员,国科大岗位教授。研究方向多模态分析理解,带领团队研发了国际首个图文音多模态大模型“紫东太初”。相关成果曾获中国电子学会自然科学一等奖,北京市自然科学二等奖,中国图像图形学会科学技术二等奖,世界人工智能大会卓越人工智能引领者奖等。主持或参与十余项国家自然科学基金重点、科技部重点研发计划和省部级重点研发计划项目等。连续多年入选全球前2%顶尖科学家,已发表高水平学术论文近200篇,谷歌学术引用20000+次,SCI他引10000+次。荣获国际学术竞赛冠军十余项。
袁 粒
北京大学深圳研究生院 助理教授
报告题目:多模态统一建模:扩散与自回归之争
报告摘要:多模态理解与生成正快速发展。当前主流多模态理解模型多以大语言模型为中枢,采用自回归式 Transformer 进行建模与推理;而多模态生成则以扩散式 Transformer 为核心架构。近年来,生成领域尝试引入自回归机制,理解领域也开始探索基于扩散的建模方式,两个方向相互借鉴,呈现出统一建模的趋势。然而,以自回归还是扩散作为统一范式仍存在争议。本报告将系统分析两种建模方式的优势与局限,探讨其作为统一主干或混合建模的可能路径,并进一步讨论生成与理解统一架构面临的关键挑战。
个人简介:袁粒,北京大学科学智能学院(深圳研究生院)助理教授、博士生导师、入选国家高层次青年人才计划,获2025年广东省卓越人工智能与机器人奖—科技进步一等奖(2/10),2021年国家优秀留学生奖(归国类)等,主持国家科技创新2030重大项目课题和国自然基金等。 研究方向是视觉为中心的多模态机器学习,代表性学术工作包括VOLO, T2T-ViT等深度神经网络框架,以第一/通讯作者在国际期刊和顶会上发表论文50余篇,包括Nature Computational Science、IEEE TPAMI/CVPR等,谷歌学术引用一万七千余次,代表应用工作包括ChatExcel、Open-Sora Plan等。
郭清沛
蚂蚁集团
报告题目:百灵全模态统一大模型的关键技术与实践
报告摘要:本报告围绕全模态统一大模型的发展趋势与核心挑战,系统介绍 Ming-flash-omni 在音、视、图、文统一建模中的关键技术,包括跨模态 MoE 融合、协同训练、理解与生成统一表征,以及图像、语音生成等方案,并结合开源实践展示其在多模态理解、生成与自然交互闭环中的能力与应用价值。
个人简介:郭清沛, 蚂蚁集团百灵多模态基础模型技术负责人,复旦大学/中科院软件所 企业导师, 研究方向包括多模态检索、多模态基础模型 和 多模态Agent,在CVPR/NIPS/ACL/ICML 等顶级会议发表论文超过30篇,授权国内外专利40余项。
论坛联系人
姓名:李琦
单位和职称:中国科学院自动化研究所研究员
邮箱:qi.li@ia.ac.cn

