

- 多模态感知与智能评测前沿论坛
- 脑机智能技术前沿与应用创新论坛
- 数字艺术与智能叙事创新论坛
- 三维成像与显示技术前沿创新论坛
- 多模态垂域大模型与端侧智能论坛
- 多模态大模型的深度认知推理前沿技术论坛
- 视觉-语音-文字多模态智能感知与交互论坛
- 机器智能前沿论坛:微视觉计算论坛
- 视频图像安全智能化演进:感知推理与对抗论坛
- AI时代下的医学影像计算论坛
- 大模型时代的视觉智能前沿论坛
- 脑启发的全天候环境感知技术与应用论坛
- 大模型泛化的边界:长尾挑战与持续学习论坛
- 仿生感知与智能传感计算论坛
- 动态与不确定环境下的鲁棒视觉智能论坛
- 类脑智能与脑机接口论坛
- 多模态生成与理解统一模型论坛
- 面向具身智能的机器视觉与数据生成论坛
- 迈向All-in-One生成式图像复原论坛
- 多媒体可信分析与隐私计算论坛
- 具身智能手术机器人论坛
- 低质量视觉处理与质量评价论坛
- 医学影像大模型论坛
- 类脑智能与医工交叉论坛
- 面向多智能体交互的社会智能论坛
- 结构化视觉理解论坛
- 空天时空智能视觉及应用论坛
- 复杂场景下基础模型感知理解增强论坛
- 沉浸式智能媒体技术论坛
- 多模态数据的理解与生成论坛
- 多智能体协同交互论坛
- 数字文化遗产与文化智能论坛
- 深度伪造治理技术论坛
- 视觉大模型高效感知与轻量化论坛
- 生成式情感智能论坛
- 多模态交互与智能感知前沿技术论坛
- 遥感智能解译论坛:大模型还是小模型?
- 可信多模态大模型青年论坛
- 开放动态环境下的持续学习与智能演进论坛
- 物理知识引导的高效表征、学习与优化论坛
- 机器感知与智能论坛
- 三维建模生成与具身智能论坛
- 极端成像和处理前沿论坛
- 多模态生成与具身应用前沿技术论坛
- 脑机接口与脑信息智能解码论坛
- 具备物理认知的视觉智能技术前沿论坛
- 多模态视觉与空间智能前沿论坛
论坛简介
随着大模型与多模态智能技术的快速发展,视频与图像安全正由内容层防护迈向涵盖感知可靠性、推理一致性与对抗鲁棒性的系统性安全阶段。与此同时,生成内容对人类认知、判断与决策心理的影响日益凸显,视觉误导、认知偏置与策略诱导等问题成为智能安全的重要隐患。本专题论坛以“视频与图像安全的智能化演进:感知、推理与对抗”为主题,聚焦生成式内容安全、视觉感知鲁棒性、多模态推理风险以及对抗环境下的人机认知与心理博弈问题,系统探讨大模型时代视频与图像安全面临的新挑战与发展路径。
论坛主席
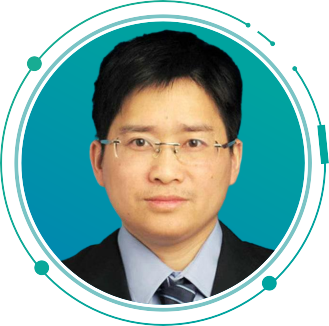
黄凯奇
中国科学院自动化研究所 研究员
个人简介:黄凯奇,中国科学院自动化研究所研究员、博士生导师,所党委委员、学术委员会委员,智能系统与工程研究中心主任,中国科学院大学特聘教授。IAPR Fellow、CSIG视频图像与安全专委会主任、CAAI智能决策专委会副主任、中国指控学会常务理事。围绕图像理解、认知决策等领域,发表论文200余篇,多次获得国际/国家学术会议最佳论文。授权国家发明专利百余项,获得国家科技进步二等奖、中国指挥与控制学会科技进步奖一等奖等多个奖项,担任包括IEEE汇刊等多个国际期刊的副主编和重要国际会议主席。获得国家级领军人才、科技部中青年科技创新领军人才、CCF-IEEE CS青年科学家、国家自然科学优秀青年基金等荣誉。
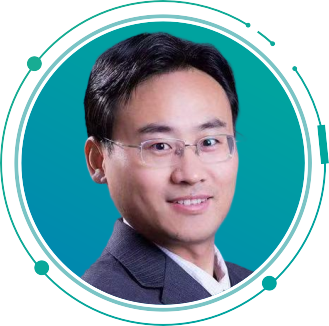
马思伟
北京大学 教授
个人简介:马思伟,北京大学博雅特聘教授,IEEE Fellow,国家杰出青年科学基金获得者,视频与视觉技术国家工程研究中心副主任。主要研究方向为视频编码与处理,承担多项国家自然科学基金、863计划、科技支撑等国家级课题。曾获国家技术发明奖一等奖(排名2)、北京市科技进步一等奖(排名1)、科学探索奖等奖励。
论坛讲者信息
雷 震
中国科学院自动化研究所 研究员
报告题目:人脸深度伪造检测新进展
报告摘要:本报告将讲述人脸深度伪造领域的最近进展。针对伪造人脸检测特征线索提取问题,提出了动态轮廓卷积(Dynamic contour convolution, DCConv)和Mamba网络结构结合的方式,可以更有效的建模更大范围的空间关系,从而提升特征判别性,提高检测的准确性。针对深度伪造手段层出不穷的问题,我们将深度伪造检测建模成一个连续学习问题,提出由真人和假体组成的混合专家结构来学习不同的样本分布;为了防止灾难性遗忘,提出同时对特征空间和梯度方向增加正交化约束,提高连续学习的有效性。在多种场景上的实验结果表明,本报告所提出的方法不论对深度伪造检测有效线索提取还是模型持续更新均有较好的效果。
个人简介:雷震,男,博士,IEEE Fellow,IAPR Fellow,AAIAFellow。中国科学院自动化研究所研究员,中国科学院大学人工智能学院岗位教授,中国科学院香港创新院人工智能与机器人研究中心教授,香港理工大学客座教授,博士生导师,入选国家青年高层次人才计划,IEEE生物识别委员会(IEEEBiometricCounci)杰出讲师。其主要研究方向为视频分析与理解,生物特征识别,人工智能基础理论,发表论文200余篇,Google Scholar文章引用次数38000余次,H-index:89,爱思唯尔中国高被引学者(2020-2024),入选全球前2%顶尖科学家榜单。
庞彦伟
天津大学 教授
报告题目:基于视觉语言模型的图像视频分割
报告摘要:近年来,视觉语言模型在跨模态理解方面取得了突破,为图像视频分割带来了新的发展机遇,但如何高效迁移视觉语言模型至图像视频分割仍面临挑战。本报告将介绍团队近年在该方向上的研究进展。围绕图像分割,重点介绍团队在开放词汇分割、无训练分割等方向的进展;围绕视频分割,重点介绍团队在开放词汇分割、运动指代分割等方向的进展。
个人简介:庞彦伟,天津大学二级教授,天津市类脑智能技术重点实验室主任。长期研究视觉智能感知技术和超低场磁共振成像技术。入选国家万人计划科技创新领军人才、天津市杰出人才、教育部青年长江学者。主持科技创新2030重大项目、国家基金委国家重大科研仪器研制项目、优青项目、重点项目等。发表学术论文200余篇,授权中美国家发明专利50余件。连续9年爱思唯尔中国高被引学者。获省部级科技奖一等奖3项。任中国图象图形学学会常务理事,中国人工智能学会智能光学成像专委会副主任。
陈健生
北京科技大学 教授
报告题目:视觉智能模型的脆弱性挖掘与鲁棒性加固
报告摘要:视觉智能模型在各类场景的广泛应用,使其安全可信性成为亟待解决的核心问题,而模型脆弱性与鲁棒性不足仍是制约其规模化落地的关键瓶颈。本报告围绕上述挑战,系统呈现报告人近三年在视觉智能模型安全领域的系统性研究成果。首先,针对不同视觉任务与模型架构,深入挖掘其内在脆弱性,提出一系列创新性攻击范式,揭示模型安全隐患的核心机理。进而,针对各类安全威胁,构建全方位的鲁棒性加固技术体系,提出多种高效防护方案,有效提升模型抗攻击能力与可靠性。相关研究成果发表于领域顶会顶刊,为视觉智能系统的安全演进提供重要理论支撑与技术借鉴。
个人简介:陈健生,北京科技大学计算机与通信工程学院教授,计算机科学与技术系系主任,博士生导师。主要研究方向为可信人工智能与人机协同,包括鲁棒的图像识别检测与生成、多模态大模型对抗鲁棒性、可控三维场景与人体姿态重建、图像与视频的可信理解等。作为负责人主持国家自然科学基金,科技部重大项目课题,重点研发计划创新特区,北京高校英才计划在内的科研项目十余项。在包括TPAMI、IJCV、Nature Communications、CVPR、ICCV、NeurIPS在内国际期刊和会议上发表学术论文百余篇。曾获北京市科学技术一等奖,北京市自然科学一等奖、CSIG自然科学二等奖。
胡晰远
北京工业大学 教授
报告题目:面向生成伪造人像的多特征融合可解释性检验技术
报告摘要:随着生成模型与深度伪造技术的快速发展,人像伪造门槛显著降低,伪造质量日趋逼真。然而,完全由数据驱动的端到端深度检测模型存在黑盒特性,可解释性差、可理解度低,可信程度难以评估,难以满足法庭科学对影像物证检验鉴定的要求。为此,本报告提出从物理、生理和数字特征三个维度,挖掘并提炼人像视频图像中难以被伪造模型模拟和改变的本质特征,构建具有物理生理意义的可解释性鉴伪特征集;在此基础上,设计跨模态多特征融合的可解释性检验模型,建立深伪视频人像多特征可信融合检验体系,以提升检测模型的稳健性与准确率。最后,对伪造人像图像/视频检测的未来发展趋势进行展望。
个人简介:胡晰远,北京工业大学计算机学院教授,博士生导师。在人工智能与计算机视觉、信号自适应分解理论及应用等领域开展研究工作,出版专著两部,在Nature Communications, IJCV,IEEE T-SP等主流期刊和会议中发表论文100余篇,主持多项国自然和重点研发计划课题,牵头制订国家和公安行业标准各1项,担任中国感光学会理事,国际期刊《Pattern Recognition》副主编,中文期刊《计算机工程》执行编委。曾获公安部科技进步一等奖,中国发明协会创新成果奖二等奖,中国计算机学会科技进步优秀奖和中国感光学会青年科技奖。
胡世宇
新加坡南洋理工大学 Research Fellow
报告题目:开放环境中的视觉理解可靠性:从鲁棒感知到语义一致性
报告摘要:随着计算机视觉从基准数据集上的识别任务发展到开放环境中的持续感知与决策支持,研究关注点正由性能评估转向行为可靠性。报告结合视觉系统在真实场景中的表现,讨论其性能瓶颈随任务形态的变化。在感知层面,遮挡、尺度变化、快速运动与长时序漂移使环境本身成为持续扰动源,系统可靠性首先取决于在复杂条件下的鲁棒性,需要通过数据与评测刻画。在理解层面,长视频与多模态信息使错误不再仅表现为识别偏差,而体现为事件解析、时序关系与因果一致性的失效。在更开放情境中,视觉系统还可能受到语义诱导与情境误导,产生稳定但错误的判断。结合视觉跟踪评测与长视频理解相关研究,报告从开放环境评测角度分享对视觉理解可靠性的若干观察与思考。
个人简介:胡世宇,新加坡南洋理工大学博士后研究员,主要从事计算机视觉、多模态学习与大语言模型相关研究。她已在 TPAMI、IJCV、NeurIPS 等国际顶级期刊与会议发表论文30余篇,其中多篇论文入选 oral / highlight。她开发了 VideoCube、SOTVerse、BioDrone 等开源研究平台,面向复杂视觉场景与长期视频理解任务,已被全球130余个国家和地区的研究者使用。她在 IJCAI、ECAI、ICIP 等国际会议主讲教程,并长期担任多个国际会议与学术期刊的审稿人。
论坛联系人
姓名:考月英
单位和职称:北京市科学技术研究院高级工程师
邮箱:kaoyueying@bjast.ac.cn

